03 · Tema 3 de 6 · máx. 26,5k views morno (calor 2 de 5; máx. 26,5k views)
Hugging Face publica treinamento aberto para IA programar em diferentes ambientes
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
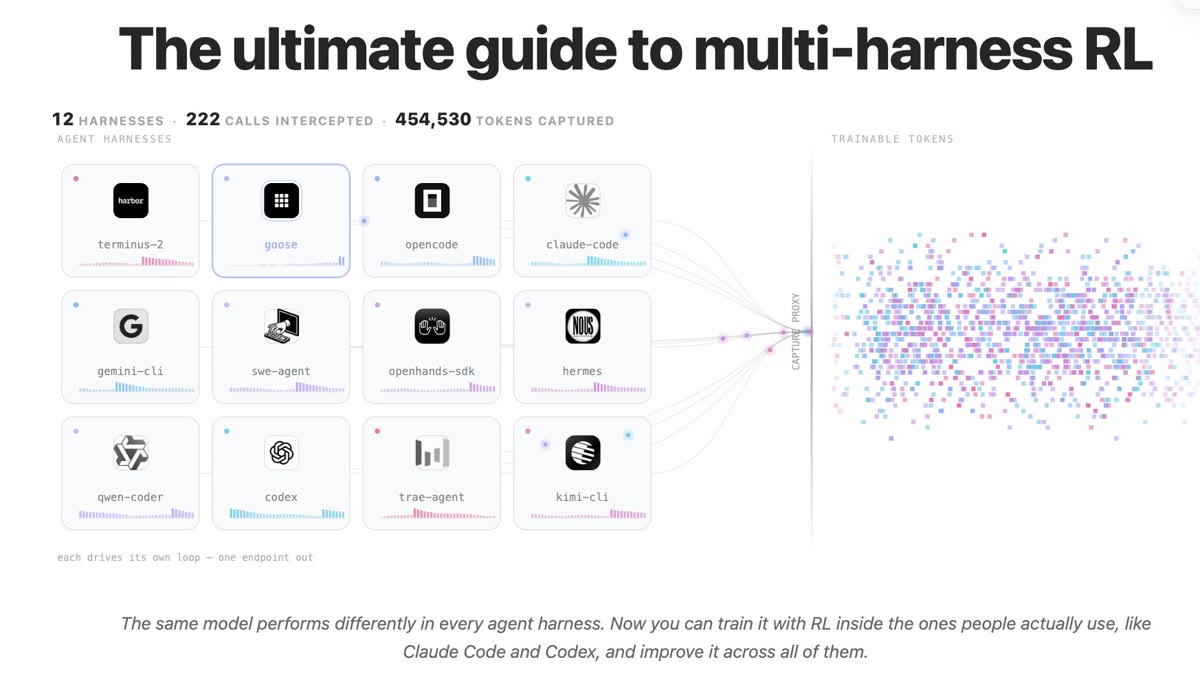
A Hugging Face publicou em 02/10, às 11h51 BRT, um guia e recursos abertos para treinar IA em diferentes ambientes de programação. O método usa aprendizado por reforço, em que o sistema pratica tarefas e recebe uma recompensa pelo resultado, sem exigir mudanças nos programas que coordenam seu trabalho. Segundo a equipe, o LFM2.5-2.6B passou de 42% para 54% ao treinar em quatro ambientes, com 31% menos chamadas de ferramentas. Código, dados e sete modelos treinados foram disponibilizados; são resultados apresentados pela própria equipe, sem avaliação independente nesta edição.
Fonte oficialGuia divulgado pela Hugging Face (abre em nova aba)
Post âncora
CONFIRMADOHugging Face
Hugging Face publica treinamento para vários ambientes de programação
@huggingface ·
A Hugging Face relata que o LFM2.5-2.6B passou de 42% para 54% ao treinar em 4 ambientes de programação, com 31% menos chamadas de ferramentas. A equipe afirma ter aberto código, tarefas, dados e sete modelos treinados.
O mesmo modelo, com os mesmos pesos, alcança 62% em um harness de agente e 33% em outro.
@adithya_s_k e a equipe da @huggingface acabaram de publicar o guia definitivo de RL com múltiplos harnesses, e ele é um dos textos mais práticos sobre RL deste ano, com tudo aberto!
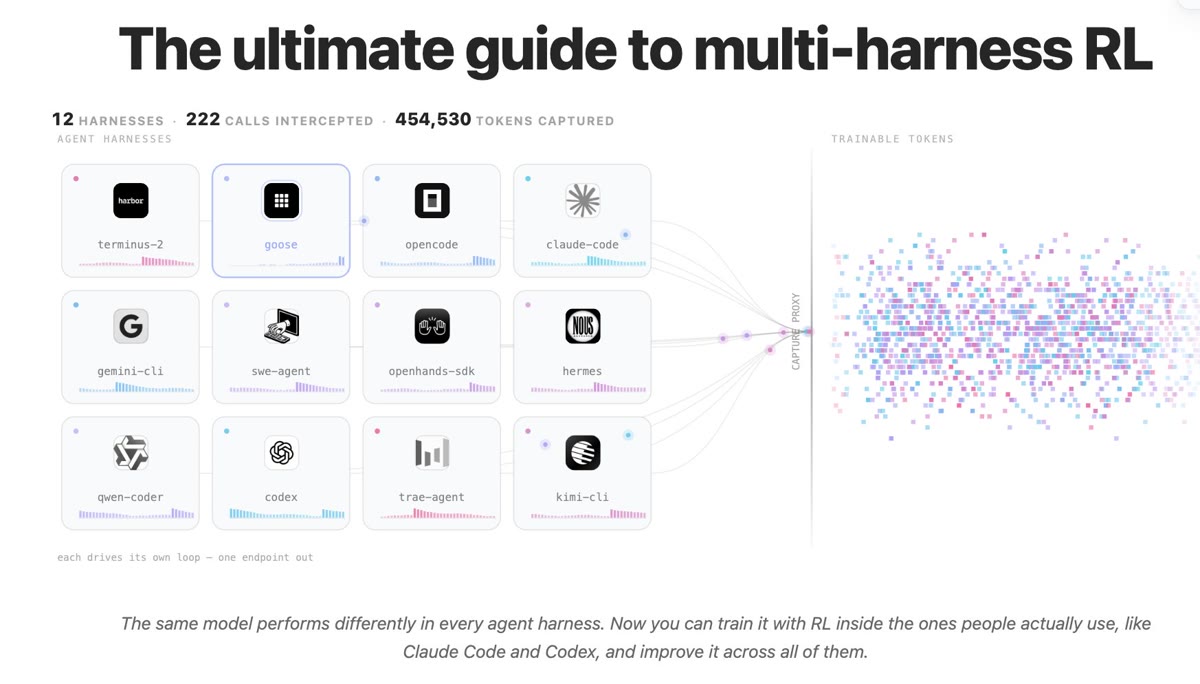
O truque é simples. Não mexa no harness. Aponte-o para um proxy em vez do modelo. O proxy fala todos os quatro formatos de API usados por agentes de programação (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini). Ele registra os ids exatos dos tokens e os logprobs amostrados pelo vLLM, e você treina com isso. Você não muda uma única linha do Claude Code, Codex ou OpenCode.
Resultados: 🔹 Treinado em 4 harnesses ao mesmo tempo, o LFM2.5-2.6B da @liquidai passou de 42% para 54% 🔹 31% menos chamadas de ferramentas, graças a um pequeno bônus por resolver tarefas em menos etapas 🔹 Treinar apenas no OpenCode levou o OpenCode de 34% para 58%, mas o modelo treinado em múltiplos harnesses melhorou em todos
Eles também tentaram o atalho ao qual todo mundo recorre: fazer fine-tuning com 3,189 execuções bem-sucedidas do Qwen3.8-27B. A imitação estabilizou em 47.5%, abaixo das duas execuções de RL. Copiar um modelo maior não leva você até lá. Praticar leva.
A melhor parte é que tudo é aberto: o proxy de captura no OpenEnv, o treinador no TRL, as tarefas, os dados de SFT, o código de treinamento e todos os sete modelos treinados. Os agentes vão funcionar em dezenas de harnesses.
Agora, modelos abertos podem ser treinados para cada um deles, por qualquer pessoa.
Leia aqui 👇
Ver original (texto do post como foi publicado)
The same model, with the same weights, scores 62% in one agent harness and 33% in another.
@adithya_s_k and the @huggingface team just released the ultimate guide to multi-harness RL, and it's one of the most practical RL write-ups this year, and everything open!
The trick is simple. Don't touch the harness. Point it at a proxy instead of the model. The proxy speaks all four API formats coding agents use (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini). It records the exact token ids and logprobs vLLM sampled, and you train on that. You don't change a single line of Claude Code, Codex or OpenCode.
Results: 🔹 Trained across 4 harnesses at once, LFM2.5-2.6B by @liquidai went from 42% to 54% 🔹 31% fewer tool calls, thanks to a small bonus for solving tasks in fewer steps 🔹 Training in OpenCode alone took OpenCode from 34% to 58%, but the multi-harness model improved everywhere
They also tried the shortcut everyone reaches for: fine-tune on 3,189 successful rollouts from Qwen3.8-27B. Imitation plateaued at 47.5%, below both RL runs. Copying a bigger model doesn't get you there. Practice does.
The best part is that everything is open: the capture proxy in OpenEnv, the trainer in TRL, the tasks, the SFT data, the training code and all seven trained models. Agents will run in dozens of harnesses.
Now open models can be trained for each of them, by anyone.
Read it here 👇