02 · Tema 2 de 4 · máx. 23,9k views frio (calor 1 de 5; máx. 23,9k views)
Lift é apresentado como uma forma de extrair dados de documentos em uma etapa
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
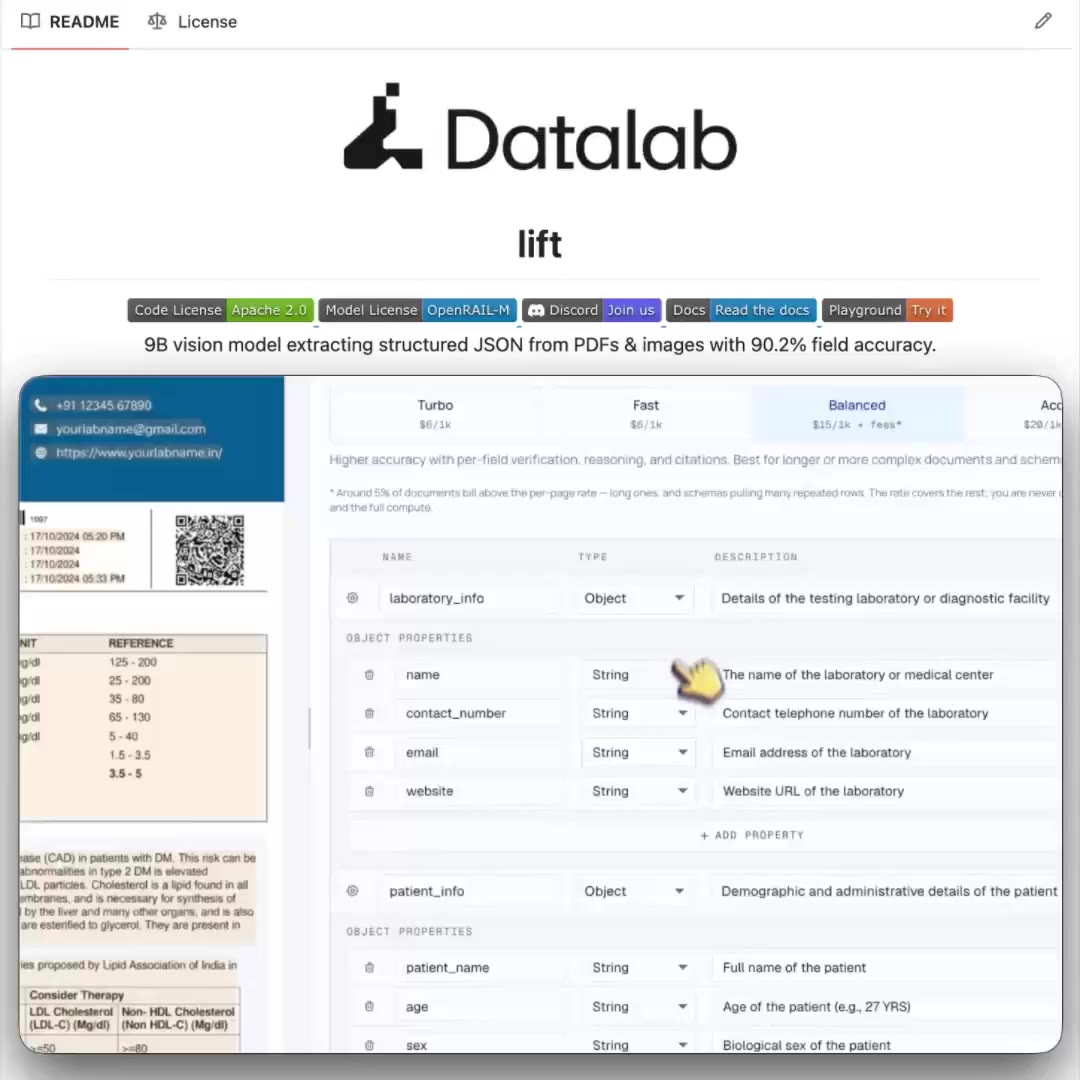
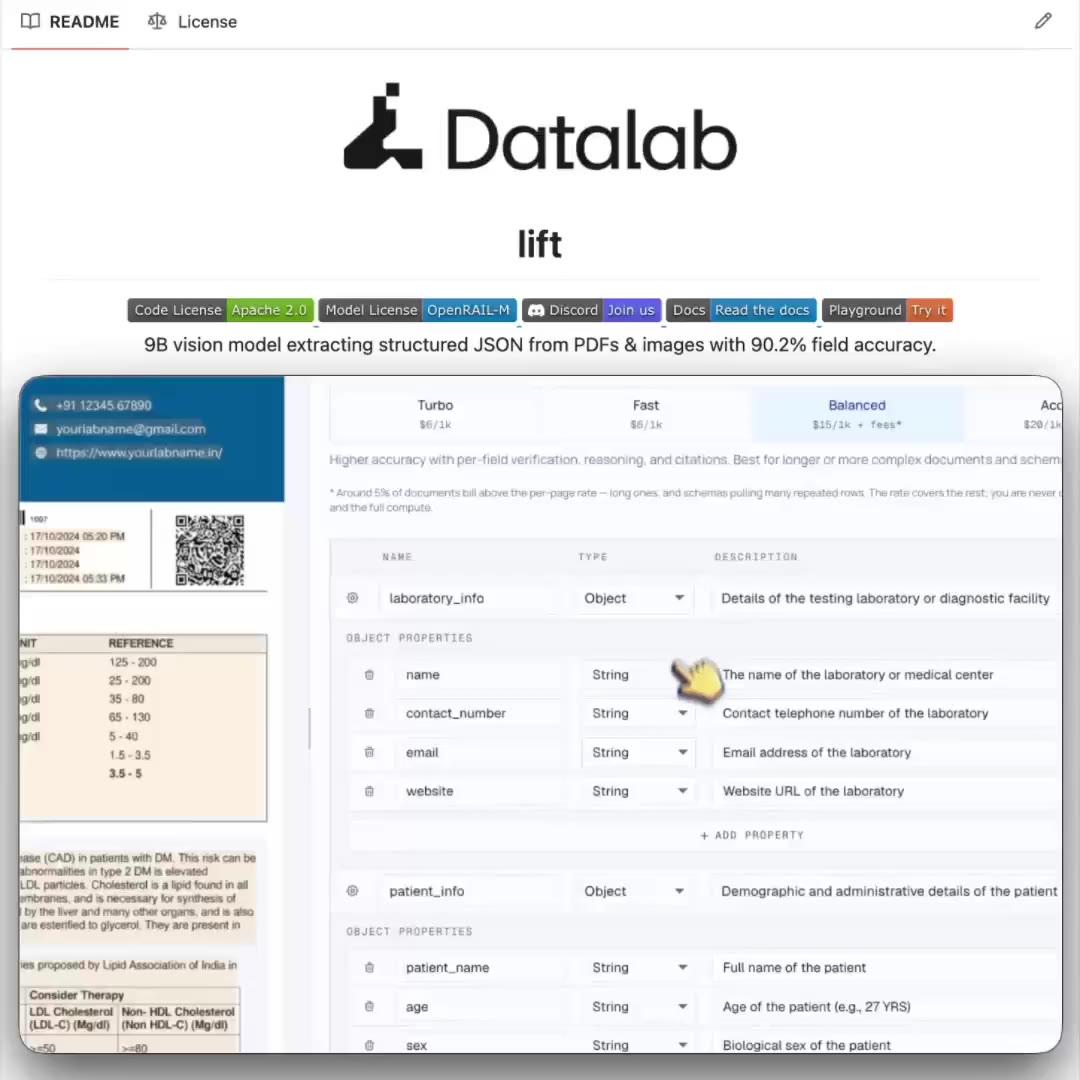
Em 03/10, às 09h30 BRT, Akshay Pachaar apresentou o Lift, da Datalab, como um sistema que recebe um PDF ou uma imagem e devolve os dados no formato solicitado. O relato informa 90.2% de acerto em 11,000 campos e velocidade 3x maior que Gemini Flash 3.5, além da possibilidade de execução em infraestrutura própria. O autor não é a fonte oficial do produto; resultados, licença e requisitos não foram confirmados na página oficial. A publicação inclui vídeo e um link apresentado como repositório.
Post âncora
BUILDERAkshay Pachaar, apresentação não oficial
Akshay apresenta Lift para extrair dados de PDFs e imagens
@akshay_pachaar ·
Akshay apresenta Lift, da Datalab, como um sistema de parâmetros abertos que extrai dados de documentos no formato solicitado. O relato informa 90.2% de acerto em 11,000 campos e desempenho próximo ao Gemini Flash 3.5 com velocidade 3x maior.
todo mundo está deixando passar este novo modelo de extração de JSON!
- parâmetros abertos - iguala Gemini Flash 3.5 - sendo 3x mais rápido
extrair dados estruturados de documentos geralmente exige uma sequência de OCR, um grande modelo de linguagem e código extra para corrigir JSON quebrado.
lift, da @datalabto, faz tudo isso em uma única etapa. você fornece a lift um PDF ou uma imagem junto com um esquema JSON e recebe um objeto JSON que corresponde a esse esquema.
o modelo lê todas as páginas de um documento em uma única passagem, então os valores que se estendem por várias páginas continuam saindo corretamente. funciona com qualquer documento que você consiga descrever em um esquema, de faturas a artigos de pesquisa.
veja o que você recebe com lift:
- 90.2% de precisão por campo em 11,000 campos - modelo de 9B, quase iguala Gemini Flash 3.5 com 3x a velocidade - desenvolvido para não inventar informações; retorna null se estiverem ausentes - pode ser hospedado por você com vLLM ou Hugging Face
Repositório no GitHub: https://t.co/akcdjgT6ei
(não se esqueça de dar uma estrela 🌟)
Ver original (texto do post como foi publicado)
everyone is sleeping on this new JSON extraction model!
- open-weights - matches Gemini Flash 3.5 - while being 3x faster
pulling structured data out of documents usually takes a chain of OCR, an LLM, and extra code to repair broken JSON.
lift, from @datalabto, does all of this in a single step. you give lift a PDF or image along with a JSON schema, and get back a JSON object that matches that schema.
the model reads every page of a document in one pass, so values that span multiple pages still come out right. any document you can describe in a schema works, from invoices to research papers.
here's what you get with lift:
- 90.2% field accuracy on 11,000 fields - 9B model, nearly matches Gemini Flash 3.5 at 3x the speed - built not to hallucinate; returns null if missing - self-hostable with vLLM or Hugging Face
GitHub repo: https://t.co/akcdjgT6ei
(don't forget to star 🌟)