05 · Tema 5 de 5 · máx. 10k views frio (calor 1 de 5; máx. 10k views)
Relato de pesquisa descreve treinamento de IA em quatro ambientes de programação
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
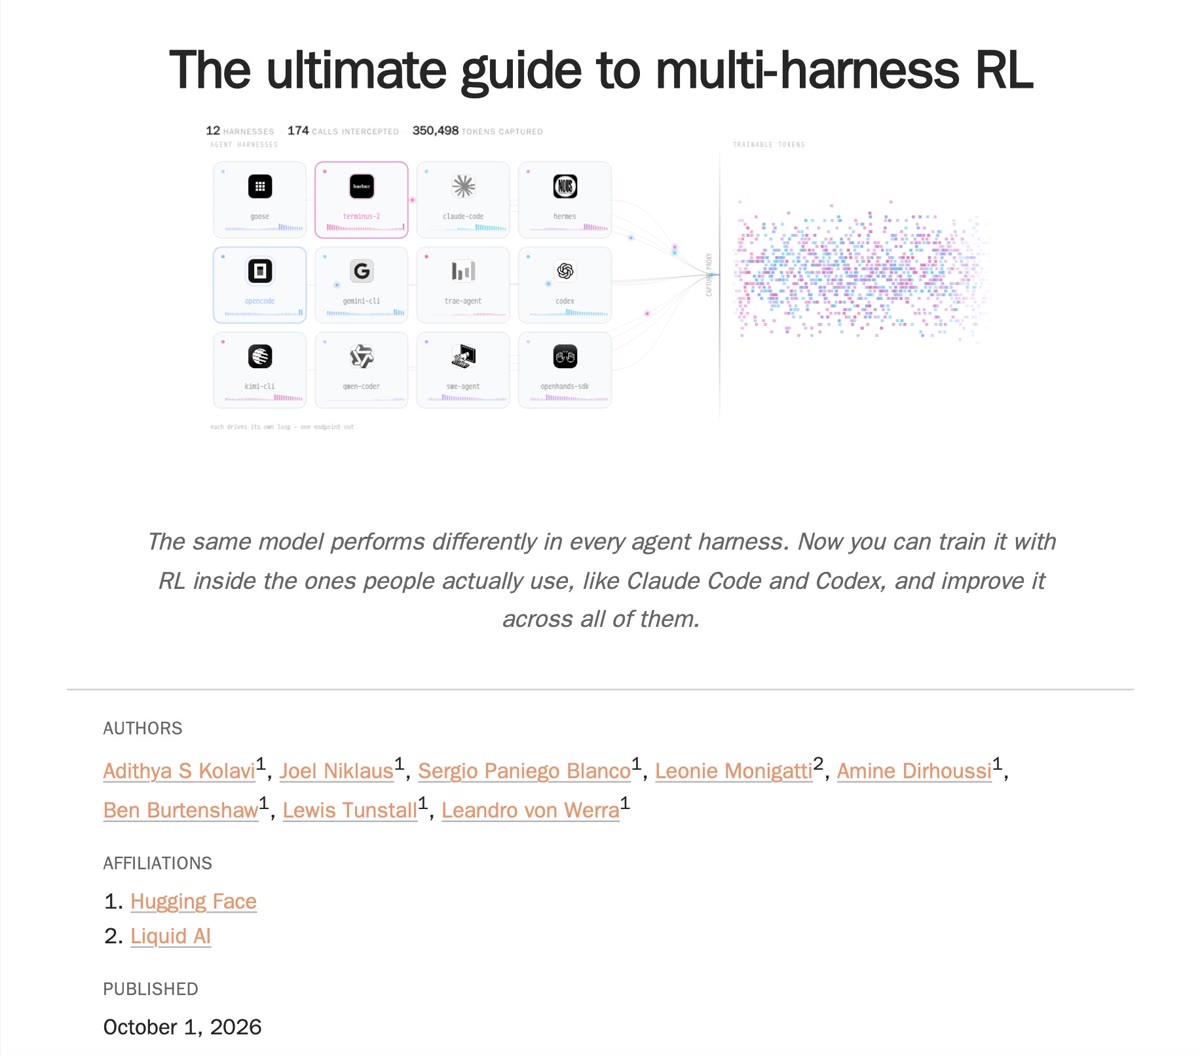
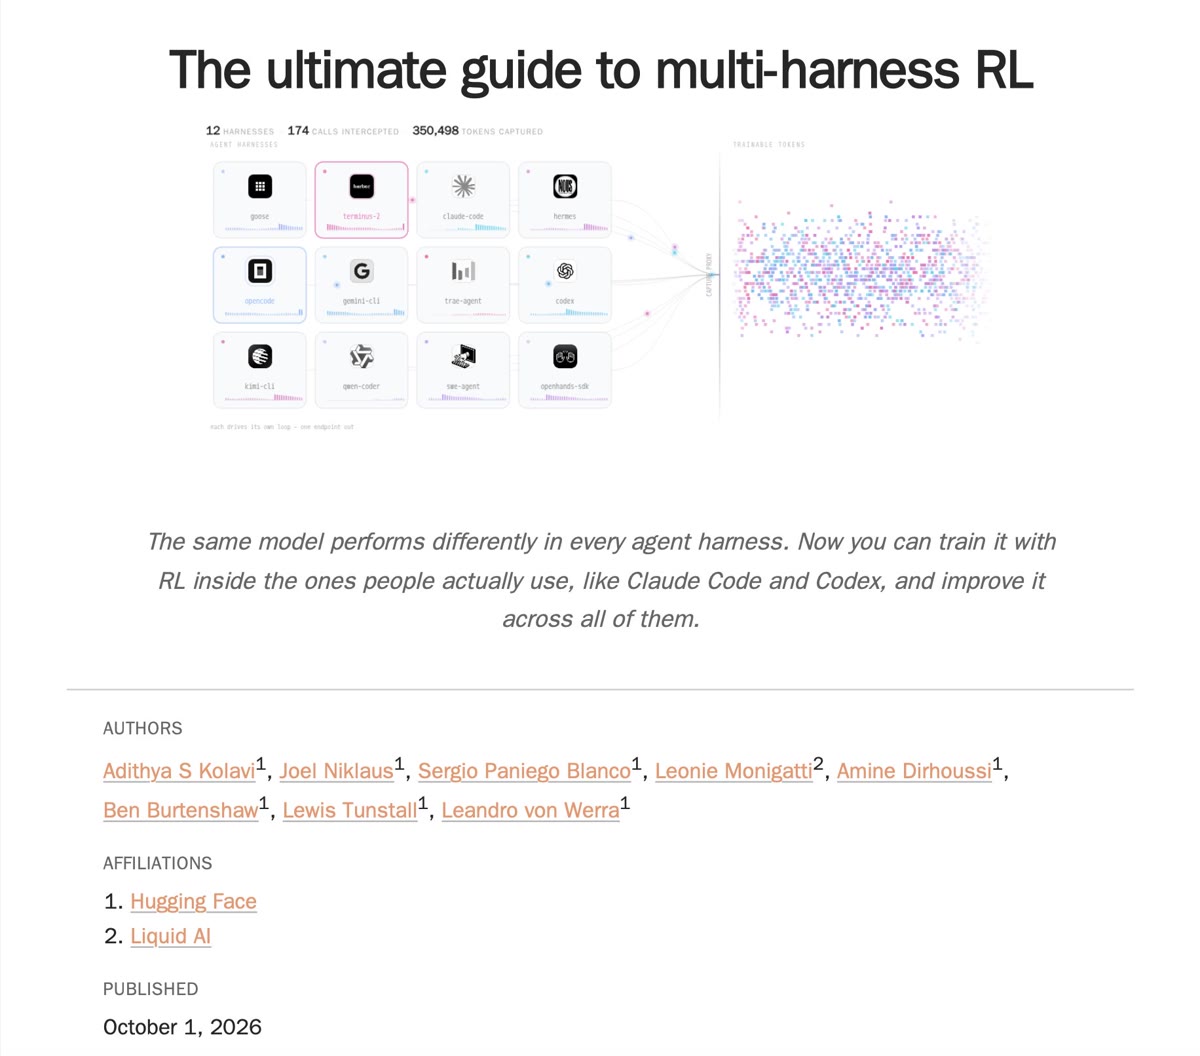
Em 04/10, às 09h30 BRT, Akshay Pachaar apresentou uma pesquisa que atribui à Hugging Face sobre treinar a mesma IA com Claude Code, Codex, OpenCode e Mini-SWE-Agent. A ideia é melhorar seu funcionamento em diferentes harnesses, programas que organizam ferramentas e tarefas da IA. Segundo o relato, a proporção de tarefas inéditas resolvidas na primeira tentativa passou de 42.2% para 54.2%, com 31% menos chamadas de ferramentas nas tarefas resolvidas pelas duas versões comparadas. O próprio texto aponta limitações do experimento. É uma apresentação de terceiro abaixo da barra de alcance; o estudo não foi confirmado na página oficial.
Post âncora
BUILDERAkshay Pachaar, apresentação não oficial de pesquisa
Relato descreve pesquisa de treinamento com quatro harnesses
@akshay_pachaar ·
O autor apresenta uma pesquisa atribuída à Hugging Face na qual a taxa de tarefas resolvidas na primeira tentativa passou de 42.2% para 54.2% após treinamento em quatro ambientes. Também relata 31% menos chamadas de ferramentas nas tarefas resolvidas tanto pela versão treinada quanto pela original.
A HuggingFace acaba de fechar uma grande lacuna na engenharia de harnesses!
(o guia definitivo de aprendizado por reforço com múltiplos harnesses)
A mesma IA com pesos abertos pode ter bom desempenho dentro de um harness e depois perder precisão ou produzir chamadas de ferramentas inválidas quando transferida para outro.
Isso acontece porque o treinamento dentro de uma interface pode ensinar à IA seus nomes específicos de ferramentas, formatos de saída, estrutura de contexto e fluxo de controle. A IA aprende a operar o harness, e não apenas a resolver a tarefa.
Pesquisadores da Hugging Face testaram uma abordagem mais portátil chamada aprendizado por reforço com múltiplos harnesses. Em vez de treinar uma IA por meio de uma única interface de execução de tarefas, eles a treinaram por meio de Claude Code, Codex, OpenCode e Mini-SWE-Agent.
Para tornar isso possível, conectaram três sistemas abertos.
→ 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 fornece uma interface padrão entre harnesses de execução de tarefas, ambientes de aprendizado por reforço e treinadores. Seu proxy de captura fica entre o harness e o servidor da IA, registrando os tokens exatos e as probabilidades de geração necessários para o treinamento.
→ 𝗛𝗮𝗿𝗯𝗼𝗿 executa sistemas de IA em tarefas dentro de contêineres. Mantém a tarefa, o harness e o ambiente isolado independentes, permitindo que a mesma tarefa seja tentada por meio de diferentes harnesses sem reconstruir o ambiente.
→ 𝗧𝗥𝗟 é a biblioteca de código aberto da Hugging Face para pós-treinamento de IAs de linguagem. Ela usa as trajetórias capturadas por 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 para atualizar a IA por meio de aprendizado por reforço.
O verdadeiro avanço está no ponto em que os dados de treinamento são capturados.
Cada harness mantém suas ferramentas nativas, instruções, gerenciamento de contexto, novas tentativas e ciclo de execução. Os pesquisadores não recriam esses comportamentos dentro do treinador. 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 observa as chamadas à IA que passam por cada harness real e as converte em sequências utilizáveis para treinamento.
A equipe treinou 𝗟𝗙𝗠𝟮.𝟱-𝟮.𝟲𝗕 nos quatro harnesses. A proporção de tarefas reservadas para avaliação resolvidas na primeira tentativa aumentou de 42.2% para 54.2%, com ganhos em todos os harnesses.
A IA treinada também usou 31% menos chamadas de ferramentas em tarefas que tanto ela quanto a IA original resolveram.
Treinar apenas no OpenCode também melhorou a IA, mas a maior parte desse ganho permaneceu concentrada no OpenCode. O treinamento com múltiplos harnesses distribuiu a melhoria entre as interfaces.
O experimento usou uma família de tarefas, uma semente de treinamento e exposição desigual aos dados, portanto os resultados não constituem uma classificação universal. Mesmo com essas limitações, o mecanismo importa.
IAs de código aberto não podem pressupor uma única interface de implantação. Se precisam funcionar em diferentes harnesses, essa portabilidade deve fazer parte do treinamento.
Leia o guia completo aqui: https://t.co/BFJfbFmI3J
Se você quiser entender a engenharia de harnesses e o que um harness de execução de tarefas realmente inclui, escrevi uma explicação completa para ajudar você a começar. O artigo está citado abaixo.
Ver original (texto do post como foi publicado)
HuggingFace just closed a major gap in harness engineering!
(the ultimate guide to multi-harness RL)
the same open-weight model can perform well inside one harness, then lose accuracy or produce invalid tool calls when moved to another.
this happens because training inside one interface can teach the model its specific tool names, output formats, context structure, and control flow. the model learns how to operate the harness, not just how to solve the task.
Hugging Face researchers tested a more portable approach called multi-harness reinforcement learning. instead of training a model through one agent interface, they trained it through Claude Code, Codex, OpenCode, and Mini-SWE-Agent.
to make that possible, they connected three open systems.
→ 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 provides a standard interface between agent harnesses, reinforcement learning environments, and trainers. its capture proxy sits between the harness and model server, recording the exact tokens and generation probabilities needed for training.
→ 𝗛𝗮𝗿𝗯𝗼𝗿 runs agents against containerized tasks. it keeps the task, harness, and sandbox independent, allowing the same task to be attempted through different harnesses without rebuilding the environment.
→ 𝗧𝗥𝗟 is Hugging Face’s open-source library for post-training language models. it uses the trajectories captured by 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 to update the model through reinforcement learning.
the real breakthrough is where the training data gets captured.
each harness keeps its native tools, prompts, context management, retries, and execution loop. the researchers do not recreate those behaviors inside the trainer. 𝗢𝗽𝗲𝗻𝗘𝗻𝘃 observes the model calls passing through each real harness and converts them into usable training sequences.
the team trained 𝗟𝗙𝗠𝟮.𝟱-𝟮.𝟲𝗕 across all four harnesses. the share of held-out tasks solved on the first attempt increased from 42.2% to 54.2%, with gains under every harness.
the trained model also used 31% fewer tool calls on tasks that both it and the base model solved.
training only in OpenCode improved the model too, but most of that gain stayed concentrated in OpenCode. multi-harness training spread the improvement across interfaces.
the experiment used one task family, one training seed, and unequal data exposure, so the results are not a universal ranking. even with those limitations, the mechanism matters.
open-source models cannot assume one deployment interface. if they need to work across harnesses, that portability must become part of training.
Read the full guide here: https://t.co/BFJfbFmI3J
if you want to understand harness engineering and what an agent harness actually includes, i wrote a full breakdown to help you get started. the article is quoted below.