04 · Tema 4 de 6 · máx. 67,6k views morno (calor 2 de 5; máx. 67,6k views)
Hugging Face apresenta treino de IA dentro de ferramentas reais de programação
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
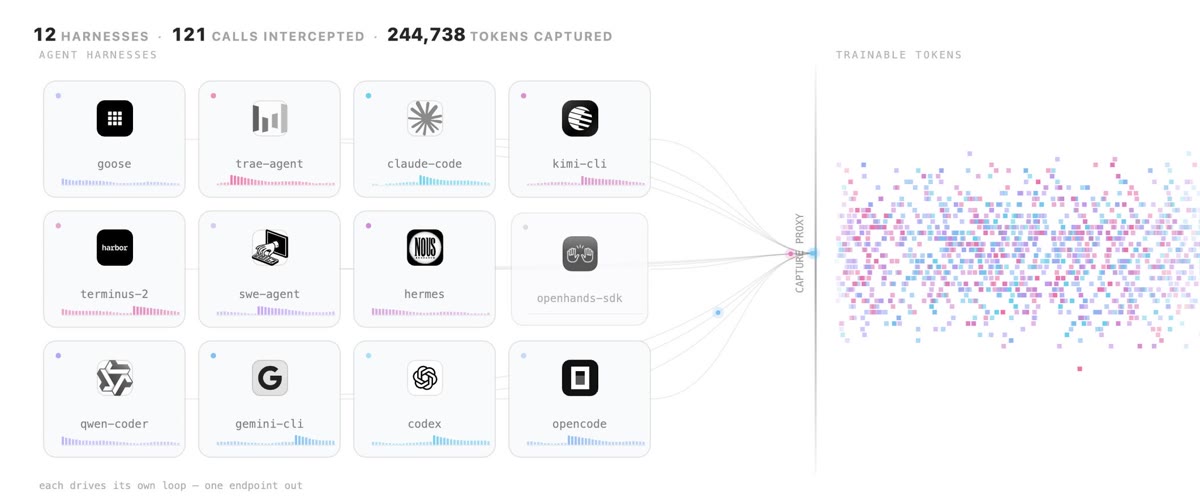
Clément Delangue, da Hugging Face, apresentou em 05/10, às 11h48 BRT, uma integração de OpenEnv e TRL para treinar IAs usando as próprias ferramentas em que elas programam, como Claude Code e Codex. O treino por reforço recompensa resultados desejados; a proposta evita reconstruir essas ferramentas em ambientes artificiais. Segundo o autor, uma mesma IA obteve 62% em Mini-SWE-Agent e 33% em Claude Code, mostrando como o ambiente de execução pode mudar o desempenho. O projeto publica código, dados e sete versões treinadas, e relata redução de 31% nas chamadas de ferramentas em tarefas que a IA já resolvia. Os resultados são dos testes apresentados pelo autor, não uma garantia para qualquer projeto.
Fonte oficialGuia indicado pelo autor (abre em nova aba)
Post âncora
BUILDERClément Delangue, Hugging Face
Hugging Face apresenta treino com OpenEnv e TRL
@ClementDelangue ·
Clément Delangue apresenta uma integração aberta para treinar IAs dentro de ferramentas de programação existentes, sem modificá-las. O relato inclui testes em diferentes ambientes e a publicação do código, dos dados e de todas as 7 versões treinadas.
Transformamos Claude Code, Codex, Hermes, Pi, @opencode e outras estruturas de execução para programação em ambientes de RL. Sem alterações nas estruturas de execução, sem alterações no código de treinamento. Qualquer modelo aberto, qualquer conjunto de tarefas, tudo de código aberto, meus amigos!
Mesmo modelo, mesmos pesos: 62% com Mini-SWE-Agent, 33% com Claude Code. Mas treinar dentro de uma estrutura de execução real normalmente significa reimplementá-la como um ambiente, então a maioria dos modelos é treinada em uma estrutura que ninguém de fato disponibiliza.
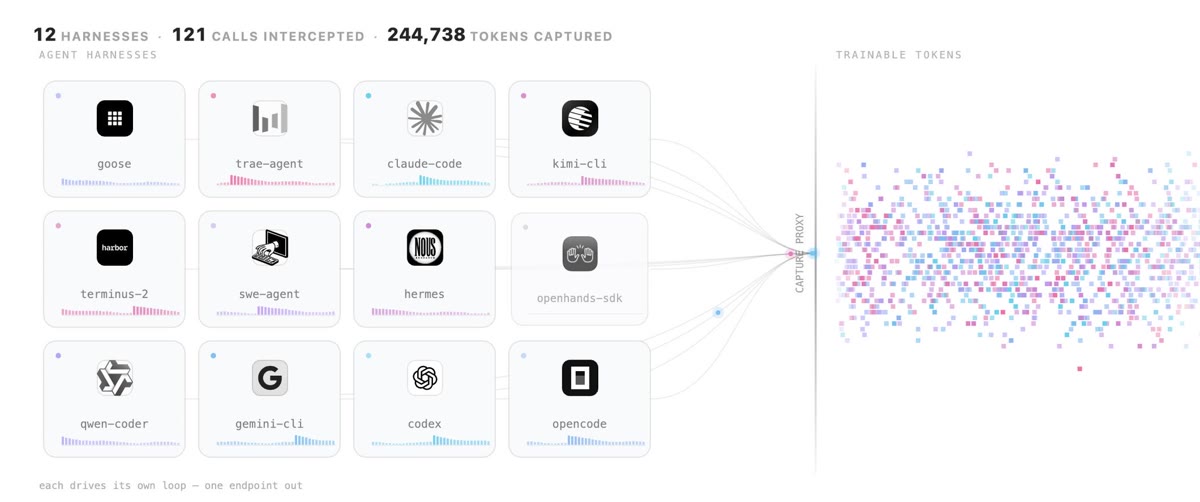
A solução é um proxy, não uma reescrita. A estrutura de execução pensa que está conversando com uma API de modelo. Na verdade, está conversando com um proxy de captura que entende os 4 formatos usados por agentes de programação (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini), encaminha para @vllm_project, registra os IDs exatos dos tokens e as probabilidades logarítmicas amostradas pelo vLLM, e entrega ao TRL sequências com as quais ele pode treinar. A estrutura de execução se torna o ambiente. 10 estruturas de execução passam por ele hoje, nenhuma modificada.
E, como você controla a recompensa, pode moldar comportamentos que a estrutura de execução nunca pediu. Adicionamos um pequeno bônus por resolver uma tarefa com menos chamadas de ferramentas: nas tarefas que já resolvia, o modelo agora usa 31% menos chamadas, em todas as estruturas de execução, e cerca de metade com Codex.
Testado com LFM2.5-2.6B da @liquidai: → Treinar em uma estrutura de execução: melhora principalmente nessa estrutura (OpenCode 34% → 58%). → Treinar em 4 ao mesmo tempo: melhora em todas as 4 (42% → 54%). → SFT com 3,189 execuções de Qwen3.8-27B em vez disso: estabiliza em 47.5%, abaixo dos dois treinos com RL.
Tudo é aberto e reproduzível: o proxy de captura no OpenEnv, o treinador no TRL, as tarefas, os dados de SFT, o código de treinamento e todos os 7 modelos treinados. Modelos maiores e treinos maiores serão os próximos.
Guia completo:
Ver original (texto do post como foi publicado)
We turned Claude Code, Codex, Hermes, Pi, @opencode and other coding harnesses into RL environments. No changes to the harnesses, no changes to the training code. Any open model, any task set, fully open source my friends!
Same model, same weights: 62% under Mini-SWE-Agent, 33% under Claude Code. But training inside a real harness normally means reimplementing it as an environment, so most models get trained in a scaffold nobody actually ships.
The fix is a proxy, not a rewrite. The harness thinks it's talking to a model API. It's actually talking to a capture proxy that speaks the 4 formats coding agents use (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini), forwards to @vllm_project, records the exact token IDs and logprobs vLLM sampled, and hands TRL sequences it can train on. The harness becomes the environment. 10 harnesses run through it today, none modified.
And because you control the reward, you can shape behavior the harness never asked for. We added a small bonus for solving a task in fewer tool calls: on tasks it already solved, the model now uses 31% fewer calls, in every harness, and about half under Codex.
Tested on LFM2.5-2.6B from @liquidai: → Train in one harness: better mostly in that harness (OpenCode 34% → 58%). → Train in 4 at once: better in all 4 (42% → 54%). → SFT on 3,189 rollouts from Qwen3.8-27B instead: plateaus at 47.5%, below both RL runs.
Everything is open and reproducible: the capture proxy in OpenEnv, the trainer in TRL, the tasks, the SFT data, the training code and all 7 trained models. Bigger models and bigger runs next.
Full guide: