02 · Tema 2 de 6 · máx. 259k views quente (calor 3 de 5; máx. 259k views)
Harness² ganha repercussão com proposta de melhorar a execução sem retreinar a IA
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
O que é novo: Novos autores detalharam o funcionamento; o maior post passou de 7.990 para 258.801 visualizações.
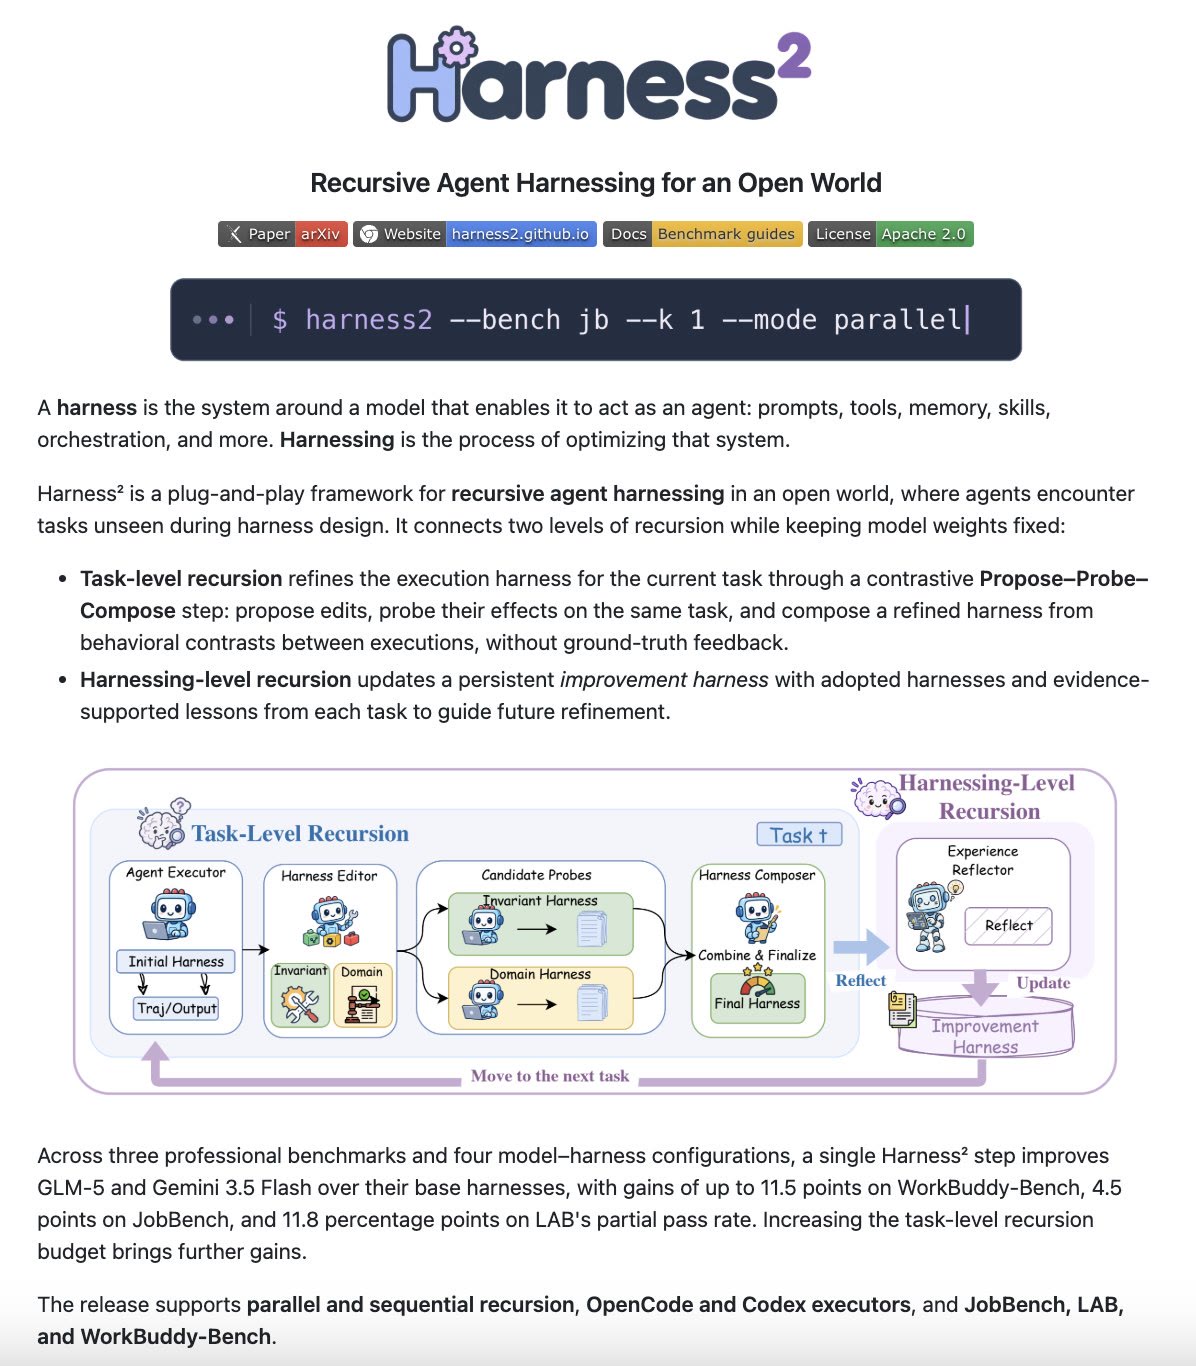
O Harness², apresentado na edição das 8h, ganhou repercussão maior em 18/10. Akshay Pachaar descreveu o projeto atribuído ao Google Research como uma forma de testar e melhorar o conjunto de instruções, ferramentas e memória que orienta uma IA, sem alterar seu treinamento. Segundo ele, o sistema compara configurações e guarda as lições para tarefas seguintes; Ashutosh Shrivastava também compartilhou o projeto. A novidade é uma explicação mais detalhada e o salto de repercussão, de 7.990 para 258.801 visualizações no maior post. Autoria, licença e resultados não foram confirmados na página oficial.
Post âncora
BUILDERRECAP não oficial — descrição do Harness²
Autor detalha como Harness² melhora o ambiente de execução
@akshay_pachaar ·
Akshay Pachaar apresenta Harness² como um projeto aberto do Google que compara mudanças nas instruções, ferramentas e memória usadas pela IA. Segundo ele, as melhorias são reaproveitadas em tarefas seguintes sem alterar os parâmetros aprendidos no treinamento.
O Google acabou de disponibilizar o código aberto do Harness².
(transforme qualquer harness em um sistema que se aperfeiçoa sozinho)
um harness é tudo que envolve o modelo, como as instruções de sistema, ferramentas, memória, habilidades e subagentes. hoje uma pessoa o projeta uma vez, e o agente executa cada nova tarefa com essa mesma configuração fixa.
Harness² permite que o agente refine essa configuração sozinho para cada nova tarefa, sem alterar os pesos do modelo.
em cada tarefa, o agente propõe alterações no seu harness, executa algumas versões candidatas e compõe um harness melhor comparando como essas execuções se comportaram.
como aprende com as diferenças entre as execuções, não precisa de uma resposta correta nem de um avaliador para a tarefa.
isso cobre uma única tarefa. Harness² também leva o que aprende de uma tarefa para a seguinte.
depois de cada tarefa, ele salva o harness escolhido junto com as lições que se sustentaram entre as execuções. na próxima vez que refina um harness, começa por essas anotações em vez de começar do zero.
isso significa que cada tarefa concluída torna a próxima rodada de alterações mais bem informada.
O Google testou isso com Gemini 3.5 Flash e GLM-5 em avaliações de trabalho jurídico, de escritório e profissional. uma rodada de alterações foi suficiente para superar os harnesses originais, e dar mais rodadas ao agente elevou as pontuações.
essas rodadas extras podem ampliar as alternativas ou aprofundar o refinamento. o agente testa vários harnesses candidatos ao mesmo tempo ou continua refinando um único passo a passo, usando OpenCode ou Codex para executar o trabalho.
você pode encontrar o repositório do Harness² aqui: https://t.co/i00WLeeFpw
eu escrevi sobre uma ideia semelhante para agentes que já estão em produção, em que o harness deveria se reparar sozinho depois de uma falha em vez de esperar que alguém depure manualmente o registro da execução.
esse texto explica como o Opik (de código aberto) da @Cometml fecha esse ciclo, passando de um registro de execução com falha para uma correção proposta e para um teste de regressão que impede a mesma falha de voltar. ele está citado abaixo.
Ver original (texto do post como foi publicado)
Google just open-sourced Harness².
(turn any harness into a self-improving system)
a harness is everything wrapped around the model, like the system prompt, tools, memory, skills, and subagents. today a person designs it once, and the agent runs every new task with that same fixed setup.
Harness² lets the agent refine that setup for each new task on its own, with the model weights left untouched.
on every task, the agent proposes edits to its harness, runs a few candidate versions, and composes a better harness by comparing how those runs behaved.
because it learns from the differences between runs, it needs no correct answer or grader for the task.
that covers a single task. Harness² also carries what it learns from one task into the next.
after each task, it saves the harness it settled on along with the lessons that held up across the runs. the next time it refines a harness, it starts from those notes instead of from scratch.
this means every finished task makes the next round of edits more informed.
Google tested this with Gemini 3.5 Flash and GLM-5 on legal, office, and professional work benchmarks. one round of edits was enough to beat their original harnesses, and giving the agent more rounds pushed scores higher.
those extra rounds can go wide or deep. the agent either tries several candidate harnesses at once or keeps refining a single one step by step, using OpenCode or Codex to carry out the work.
you can find the Harness² repo here: https://t.co/i00WLeeFpw
I wrote about a similar idea for agents already running in production, where the harness should repair itself after a failure instead of waiting for someone to debug the trace by hand.
that piece walks through how @Cometml's Opik (open-source) closes this loop, going from a failing trace to a proposed fix to a regression test that stops the same failure from coming back. it's quoted below.
Outros posts do tema 1
BUILDERRECAP não oficial — apresentação do Harness²
Publicação compartilha o repositório do Harness²
@ai_for_success ·
O autor apresenta Harness² como um projeto aberto do Google Research para ajudar sistemas de IA a melhorar o conjunto de instruções e ferramentas usado em cada tarefa.
O Google Research disponibilizou o código aberto do Harness², uma estrutura que ajuda agentes de IA a melhorar seu próprio harness em cada tarefa em que trabalham.
Repositório 👇
Ver original (texto do post como foi publicado)
Google Research open-sourced Harness², a framework that helps AI agents improve their own harness for every task they work on.
Repo 👇