04 · Tema 4 de 6 · máx. 42k views morno (calor 2 de 5; máx. 42k views)
Meta detalha a infraestrutura usada para treinar Muse Wonder
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
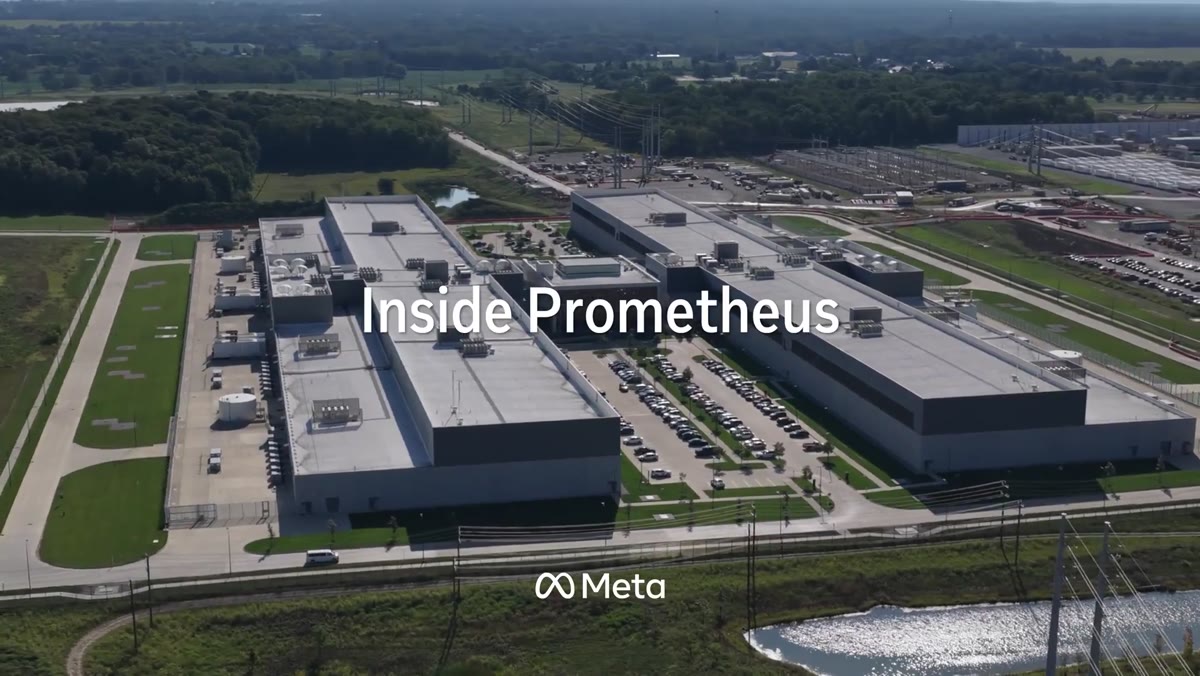
Em 19/10, às 15h14 BRT, a Meta explicou como usou o Prometheus, seu conjunto de computadores em New Albany, Ohio, para treinar a família Muse, incluindo Muse Wonder. A empresa diz que a infraestrutura tem centenas de milhares de processadores gráficos e que até uma máquina com desempenho ruim pode atrasar o treinamento inteiro. A publicação informa aproveitamento útil de 85%+ no treinamento inicial e 90%+ no aprendizado por recompensas, além de ~47K horas de GPU entre interrupções, conforme a medida apresentada pela empresa. É uma divulgação de engenharia sobre produtos existentes, sem anúncio de outra versão ou liberação de pesos.
Fonte oficialExplicação técnica indicada pela Meta (abre em nova aba)
Post âncora
CONFIRMADOAI at Meta — infraestrutura de treinamento
Meta explica como treinou Muse Wonder no Prometheus
@AIatMeta ·
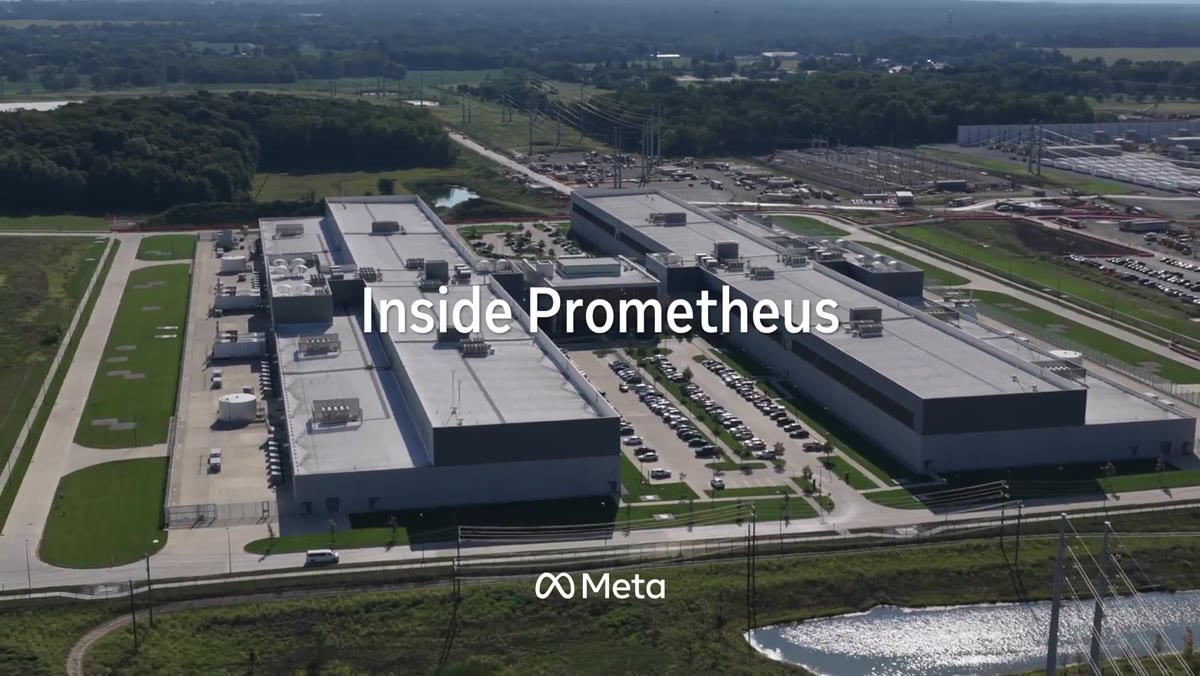
A Meta informa que treinou Muse Wonder no Prometheus e descreve como reduziu interrupções em uma infraestrutura com centenas de milhares de processadores gráficos. A empresa relata 85%+ de aproveitamento útil no treinamento inicial e 90%+ no aprendizado por recompensas.
Treinamos nossos modelos fundamentais Muse, incluindo Muse Wonder, no Prometheus, nosso supercluster em escala de gigawatts em New Albany, Ohio.
Em um supercluster com centenas de milhares de GPUs, até uma única máquina com desempenho abaixo do esperado pode desacelerar uma execução inteira de treinamento. Projetamos o Prometheus para ter resiliência em escala, alcançando 85%+ de aproveitamento útil no pré-treinamento, 90%+ no aprendizado por reforço e ~47K horas de GPU de tempo médio entre interrupções durante o treinamento do Muse Wonder.
Veja a tecnologia que faz o Prometheus funcionar:
Ver original (texto do post como foi publicado)
We trained our Muse foundational models, including Muse Wonder, at Prometheus, our gigawatt-scale supercluster in New Albany, Ohio.
Across a supercluster with hundreds of thousands of GPUs, even one underperforming host can slow an entire training run. We engineered Prometheus for resilience at scale, achieving 85%+ goodput on pretraining, 90%+ on reinforcement learning and ~47K GPU hours mean time between interruptions during Muse Wonder training.
Take a look at the tech powering Prometheus: