05 · Tema 5 de 6 · máx. 5,47k views frio (calor 1 de 5; máx. 5,47k views)
Nanbeige4.3-33B chega acompanhado de resultados e ressalvas
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
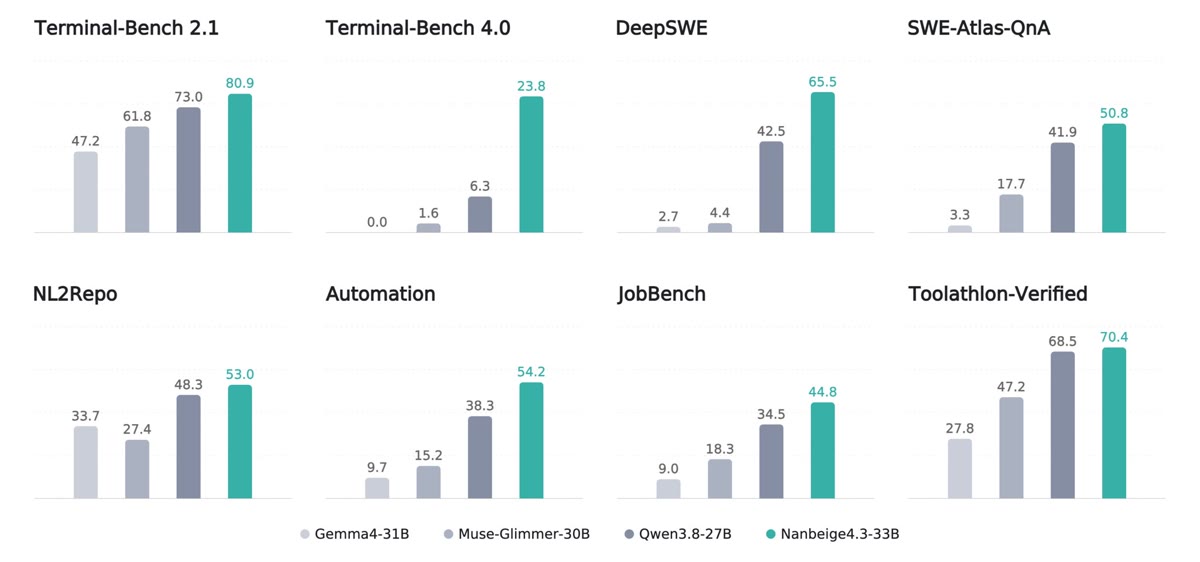
TestingCatalog noticia o lançamento de Nanbeige4.3-33B, uma IA aberta de 33 bilhões de parâmetros, uma medida de seu tamanho. A publicação destaca resultados em programação e trabalho de escritório. Separadamente, TeksEdge relata uma versão compactada de 19.1GB, mas alerta que trabalhar com documentos maiores exige mais memória e pode reduzir o desempenho. Licença, disponibilidade e resultados não foram confirmados na página oficial.
Post âncora
CONFIRMADOIMPRENSA — TestingCatalog
TestingCatalog noticia o lançamento de Nanbeige4.3-33B
@testingcatalog ·
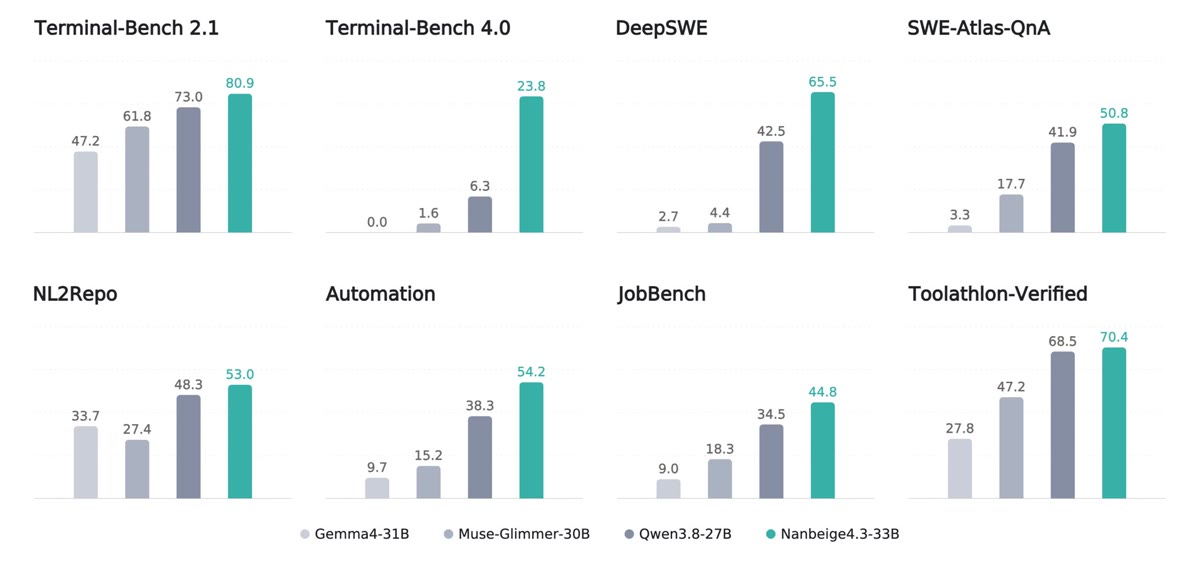
TestingCatalog noticia Nanbeige4.3-33B e reproduz alegações de liderança em testes de programação e tarefas de trabalho. A publicação também menciona uma versão menor, Nanbeige4.3-3B, planejada para o futuro.
A Nanbeige lançou Nanbeige4.3-33B, um novo modelo aberto de ponta na categoria de ~30B parâmetros.
> "Nanbeige4.3-33B lidera na maioria dos testes de referência, mostrando forte desempenho tanto em programação com agentes quanto em tarefas de trabalho colaborativo."
> O modelo supera Qwen3.8-27B, Muse-Glimmer-30B e Gemma4-31B na maioria dos testes de referência.
> Um modelo menor, Nanbeige4.3-3B, também está planejado para o futuro.
Ver original (texto do post como foi publicado)
Nanbeige released Nanbeige4.3-33B, a new SOTA open model in the ~30B parameter class.
> "Nanbeige4.3-33B leads on most of the benchmarks, showing strong performance in both agentic coding and cowork tasks."
> The model outperforms Qwen3.8-27B, Muse-Glimmer-30B, and Gemma4-31B on most benchmarks.
> A smaller model, Nanbeige4.3-3B, is also planned for the future.
Outros posts do tema 1
BUILDERUSUÁRIO — análise técnica
Relato detalha testes e limites de memória do Nanbeige
@TeksEdge ·
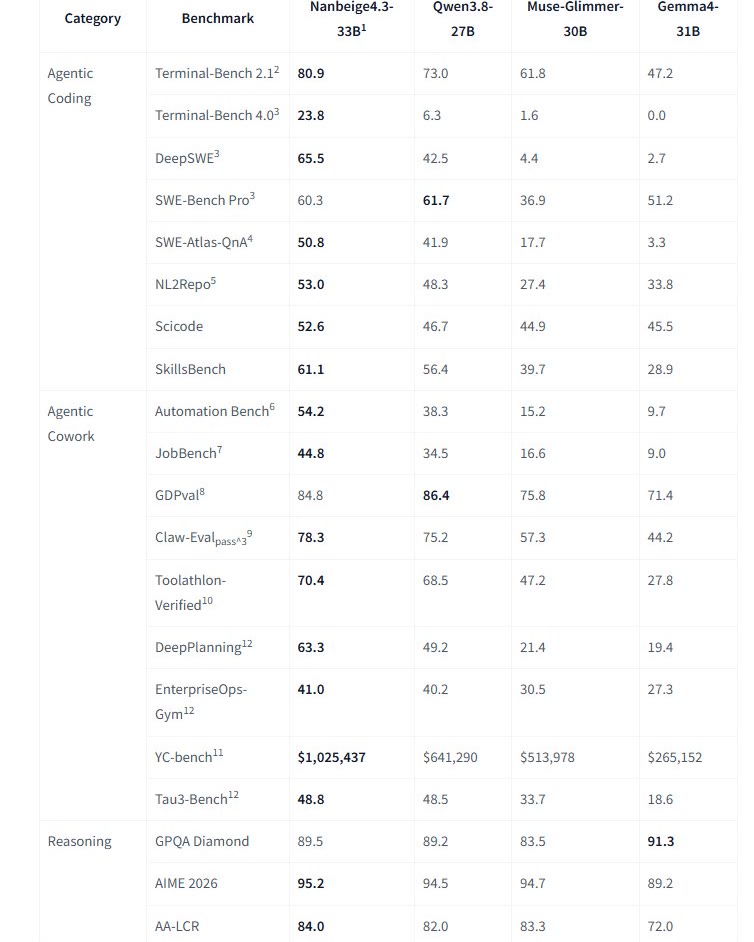
TeksEdge relata que Nanbeige4.3-33B superou Qwen3.8-27B em 18 de 20 testes publicados e tem uma versão compactada de 19.1GB. O autor alerta que o uso da capacidade máxima de contexto exige mais memória e cita queda de desempenho em testes iniciais da comunidade.
A sequência de lançamentos de modelos 30+B continua.
Um novo modelo aberto de 33B superou Qwen3.8-27B em 18 de 20 testes de referência publicados, e sua versão Q4 tem apenas 19.1GB. 👈 👀
A Nanbeige lançou Nanbeige4.3-33B.
Especificações 🧠 33B denso 💾 Q4_K_S → 19.1GB 📚 Contexto de 512K 🔓 Apache 2.0 🛠️ chamadas de ferramentas + raciocínio
Compatível com ⚙️ llama.cpp / Ollama / LM Studio / vLLM / SGLang
Os testes de agentes chamam atenção
Nanbeige → Qwen3.8-27B
Terminal-Bench 2.1 80.9 → 73.0
Terminal-Bench 4.0 23.8 → 6.3
DeepSWE 65.5 → 42.5
Automation Bench: 54.2 → 38.3
JobBench 44.8 → 34.5
DeepPlanning 63.3 → 49.2
A Nanbeige diz que avaliou os modelos com os mesmos hiperparâmetros de inferência e estruturas de execução.
Os pesos Q4 de 19.1GB podem caber em uma GPU de 24GB, mas não com contexto de 512K.
Esta é uma arquitetura Llama densa convencional com um cache KV crescente, e os primeiros testes da comunidade já mostram queda de desempenho à medida que o contexto se enche.
Ver original (texto do post como foi publicado)
30+B model release train continues.
A new 33B open model beat Qwen3.8-27B on 18 of 20 published benchmarks and its Q4 is only 19.1GB. 👈 👀
Nanbeige released Nanbeige4.3-33B.
Stats 🧠 33B dense 💾 Q4_K_S → 19.1GB 📚 512K context 🔓 Apache 2.0 🛠️ tool calling + thinking
Supported on ⚙️ llama.cpp / Ollama / LM Studio / vLLM / SGLang
Agent benchmarks are notable
Nanbeige → Qwen3.8-27B
Terminal-Bench 2.1 80.9 → 73.0
Terminal-Bench 4.0 23.8 → 6.3
DeepSWE 65.5 → 42.5
Automation Bench: 54.2 → 38.3
JobBench 44.8 → 34.5
DeepPlanning 63.3 → 49.2
Nanbeige says it evaluated the models with the same inference hyperparameters and harnesses.
The 19.1GB Q4 weights can fit on a 24GB GPU but not at 512K context won't.
This is a conventional dense Llama architecture with a growing KV cache, and early community testing is already showing performance falling as context fills.