04 · Tema 4 de 4 · máx. 23,3k views frio (calor 1 de 5; máx. 23,3k views)
Análise de Dory explica ganhos ao repetir etapas de cálculo
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
Avi Chawla publicou em 14/11, às 07h26 BRT, uma análise do Dory1.0-4B, atribuído à NVIDIA. A proposta é reutilizar partes internas da IA várias vezes para aprofundar o processamento sem armazenar uma cópia diferente para cada etapa. Segundo a análise, a pontuação no SWE-bench Verified, avaliação de correções de software, passa de 50.3 com uma repetição para 61.8 com quatro. O texto também aponta maior necessidade de processamento e limitações em perguntas de conhecimento. Os resultados e as recomendações não foram confirmados no artigo original.
Post âncora
BUILDERAvi Chawla — análise técnica não oficial
Análise explica repetições de cálculo no Dory1.0-4B
@_avichawla ·
O autor descreve Dory1.0-4B como uma IA da NVIDIA que reutiliza camadas internas para aprofundar o processamento. Apresenta ganhos em avaliações de raciocínio e programação, junto de custos adicionais e limitações em conhecimento.
A NVIDIA lançou um novo transformer com repetição de camadas:
Em vez de empilhar mais camadas, ele executa as mesmas camadas várias vezes para que um modelo de 4B possa pensar como um de 9B.
Veja como funciona:
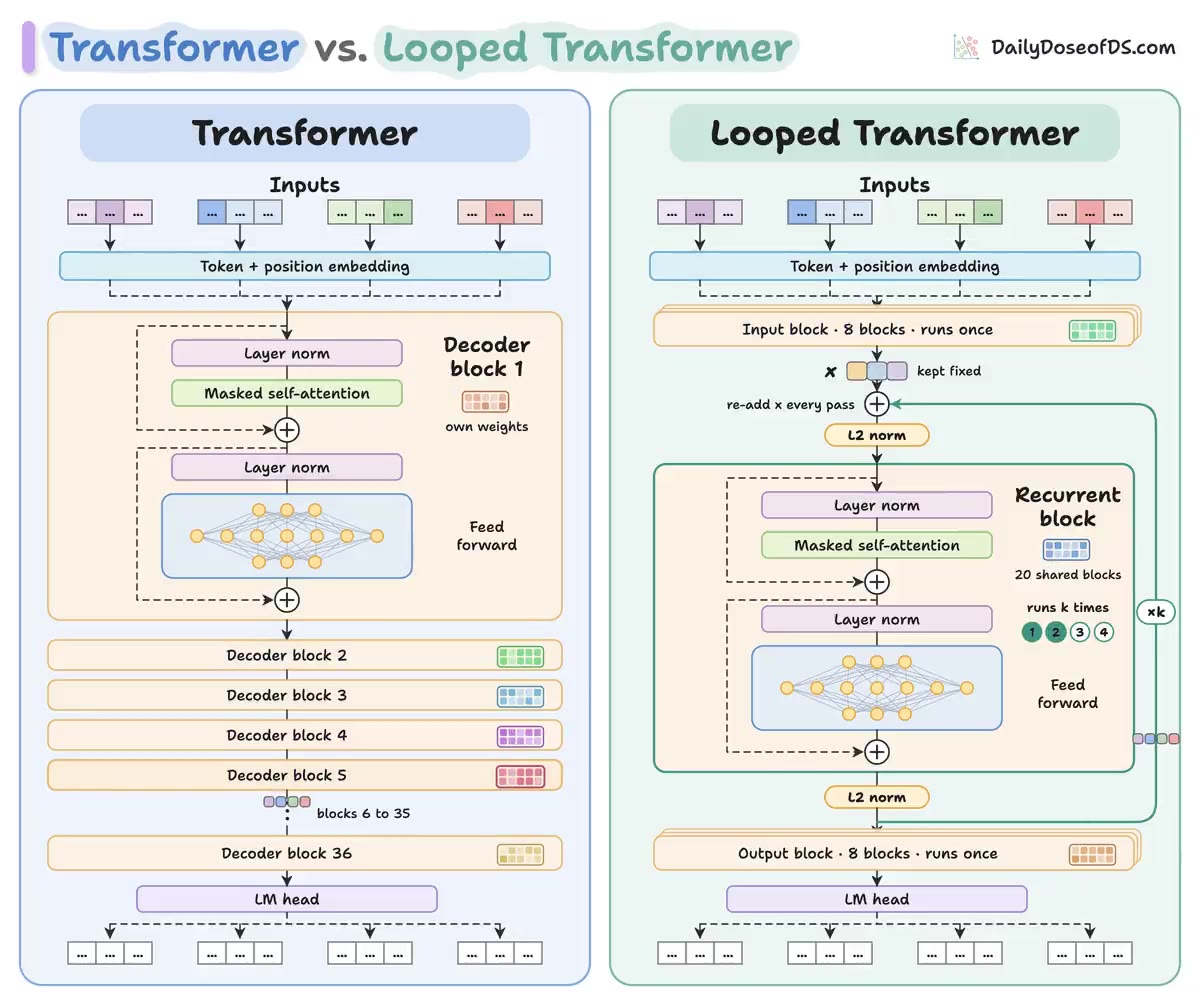
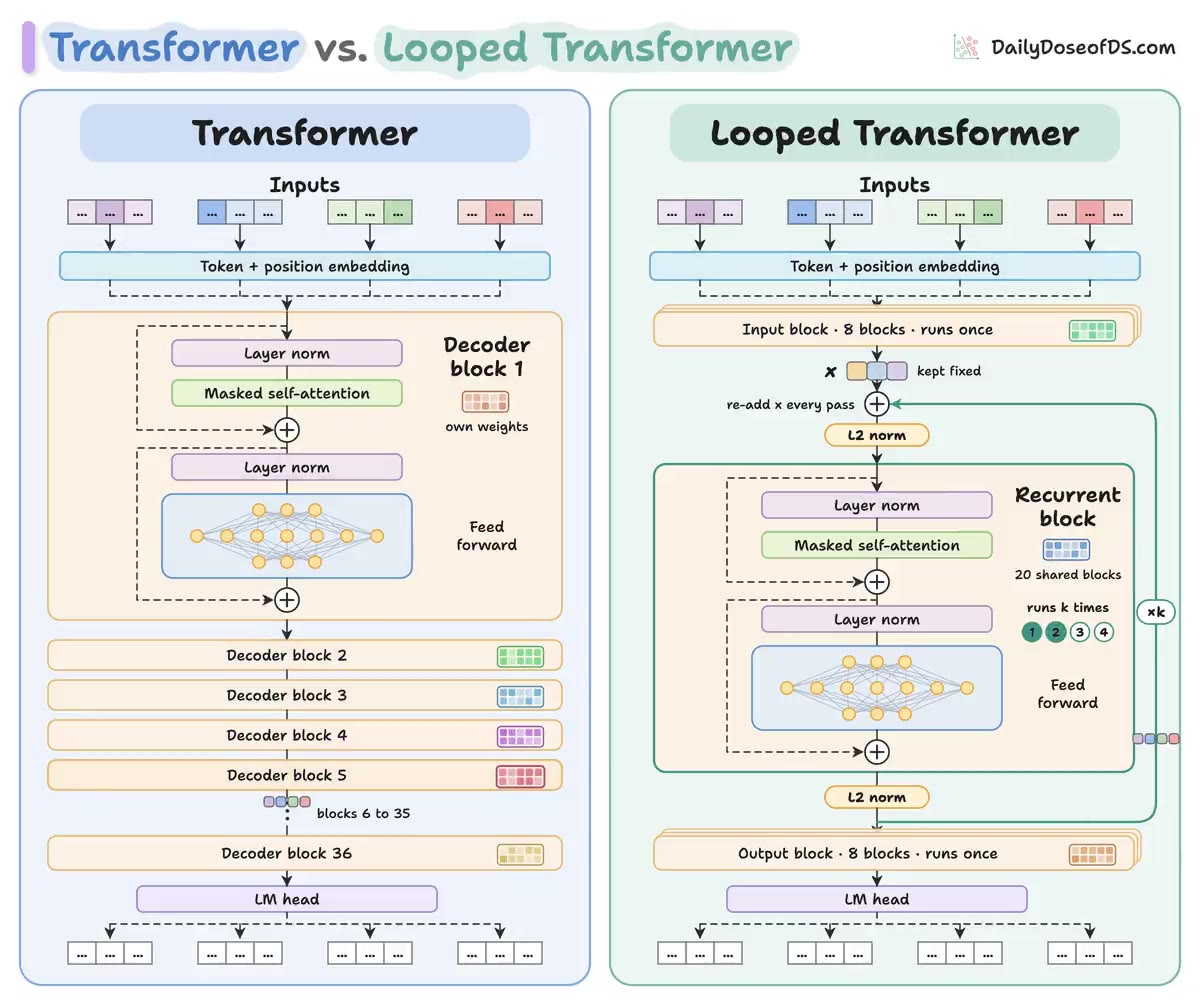
Em um transformer padrão, cada token passa uma vez por uma sequência de blocos decodificadores, e cada bloco tem seus próprios pesos.
Então, se você quiser um modelo mais profundo, adiciona mais blocos, e a quantidade de parâmetros cresce com a profundidade.
O Dory1.0-4B da NVIDIA separa essas duas coisas reutilizando uma parte de suas camadas.
O modelo é dividido em três partes:
> Um bloco de entrada com 8 blocos é executado uma vez e transforma os tokens em um estado oculto x.
> Um bloco recorrente com 20 blocos compartilhados é executado k vezes, sendo que k pode variar de 1 a 4.
> Um bloco de saída com 8 blocos é executado uma vez sobre o estado final, seguido pela cabeça do modelo de linguagem.
Antes de cada passagem pelo bloco recorrente, x é somado novamente ao estado atual, e a soma é normalizada pela norma L2.
Isso mantém a representação original do token presente em cada passagem, em vez de cada passagem enxergar apenas o que a anterior produziu.
Ambos os modelos no diagrama abaixo armazenam pesos de 36 blocos.
O transformer padrão aplica cada bloco uma vez, enquanto Dory aplica 36 blocos em k=1, 56 em k=2 e 96 em k=4, ou seja, 72, 112 e 192 camadas físicas a partir do mesmo checkpoint.
A profundidade extra realmente ajuda em tarefas de raciocínio e de agentes:
> SWE-bench Verified:
- com 1 repetição → 50.3 - com 2 repetições → 59.5 - com 4 repetições → 61.8
> Média de 12 avaliações:
- com 1 repetição → 35.17 - com 2 repetições → 39.67 - com 4 repetições → 40.60 - e, com 2 ou mais repetições, supera Qwen3.5-9B, Gemma 4 12B e Gemma 4 26B-A4B.
Mais repetições implicam mais processamento por token, mas o modelo com 4 repetições também escreve de 1.3x a 2.5x menos tokens de saída em tarefas de agentes.
Assim, 2 repetições acabam custando apenas de 1.03x a 1.25x o processamento de 1 repetição de ponta a ponta, razão pela qual a NVIDIA recomenda 2 como padrão.
Por padrão, Dory mantém um cache KV separado para cada repetição, então, com 4 repetições, as camadas recorrentes armazenam 4x o cache.
Para evitar isso, ele pode manter apenas o cache da última repetição, o que usa a mesma memória KV de um modelo normal, com apenas uma pequena mudança na precisão.
Algo a observar aqui é que a repetição ajuda o modelo a raciocinar sobre o que já sabe, mas não acrescenta conhecimento.
Por exemplo, em tarefas como AA-Omniscience, a precisão permanece em 10.0 independentemente de você executar 1 repetição ou 4, e, em tarefas que exigem muito conhecimento, como GPQA, Dory ainda fica atrás de Qwen3.5-4B.
Aqui está o artigo: https://t.co/pdrqhdCHpZ
Dito isso, a memória consumida pelas repetições depende de como o cache KV é tratado, então escrevi uma explicação completa de como esse cache funciona.
Ela aborda o que fica armazenado durante o processamento inicial, como o cache cresce durante a geração e por que ele se torna o principal gargalo de memória em contextos longos.
Leia abaixo.
Ver original (texto do post como foi publicado)
NVIDIA released a new looped transformer:
Instead of stacking more layers, it runs the same layers multiple times so a 4B model can think like a 9B one.
Here's how it works:
In a standard transformer, every token passes through a stack of decoder blocks once, and each block has its own weights.
So if you want a deeper model, you add more blocks, and the parameter count grows with the depth.
NVIDIA's Dory1.0-4B decouples the two by reusing a chunk of its layers.
The model is split into three parts:
> An input block of 8 blocks runs once and turns the tokens into a hidden state x.
> A recurrent block of 20 shared blocks runs k times, where k can be anywhere from 1 to 4.
> An output block of 8 blocks runs once on the final state, followed by the LM head.
Before every pass through the recurrent block, x is added back to the current state and the sum is L2-normalized.
This keeps the original token representation in view on every pass, instead of each pass only seeing what the previous one produced.
Both models in the diagram below store 36 blocks of weights.
The standard transformer applies each block once, while Dory applies 36 blocks at k=1, 56 at k=2, and 96 at k=4, i.e., 72, 112, and 192 physical layers from the same checkpoint.
The extra depth is actually helpful on reasoning and agentic tasks:
> SWE-bench Verified:
- at 1 loop → 50.3 - at 2 loops → 59.5 - at 4 loops → 61.8
> 12-benchmark average:
- at 1 loop → 35.17 - at 2 loops → 39.67 - at 4 loops → 40.60 - and with 2 or more loops, it beats Qwen3.5-9B, Gemma 4 12B, and Gemma 4 26B-A4B.
More loops implies more compute per token, but the 4-loop model also writes 1.3x to 2.5x fewer output tokens on agentic tasks.
So 2 loops end up costing only 1.03x to 1.25x the compute of 1 loop end to end, which is why NVIDIA recommends 2 as the default.
By default, Dory keeps a separate KV cache for every loop, so at 4 loops the recurrent layers store 4x the cache.
To avoid this, it can keep only the cache from the last loop, which uses the same KV memory as a normal model with only a small change in accuracy.
One thing to note here is that looping helps the model reason over what it already knows, but it does not add knowledge.
For instance, on tasks like AA-Omniscience, accuracy stays at 10.0 whether you run 1 loop or 4, and on knowledge-heavy tasks like GPQA, Dory still trails Qwen3.5-4B.
Here's the paper: https://t.co/pdrqhdCHpZ
That said, how much memory looping costs comes down to how the KV cache is handled, so I wrote a full breakdown of how KV caching works.
It covers what gets cached during prefill, how the cache grows during decoding, and why it becomes the main memory bottleneck at long context.
Read it below.