06 · Tema 6 de 6 · máx. 22,9k views frio (calor 1 de 5; máx. 22,9k views)
FrontierCode avalia código que os mantenedores aceitariam; líderes ainda falham em mais de 40%
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
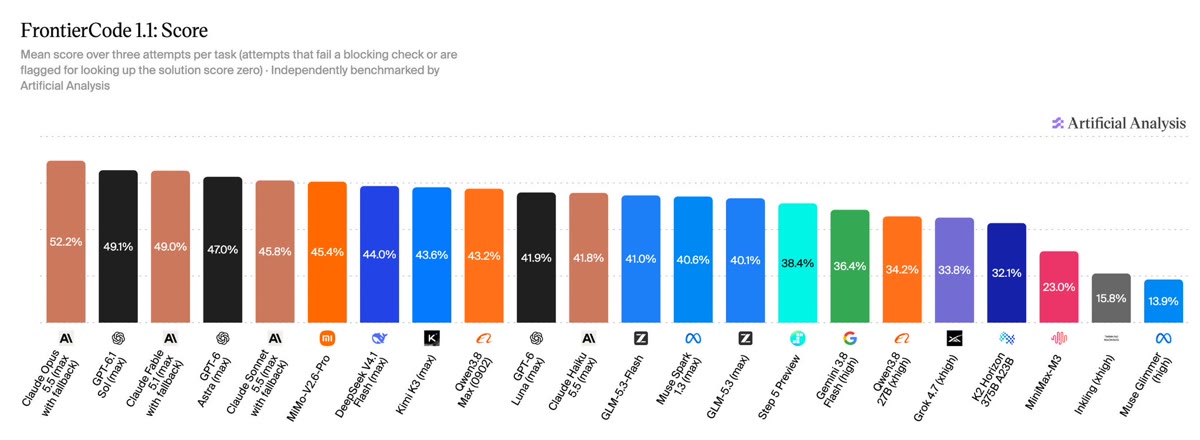
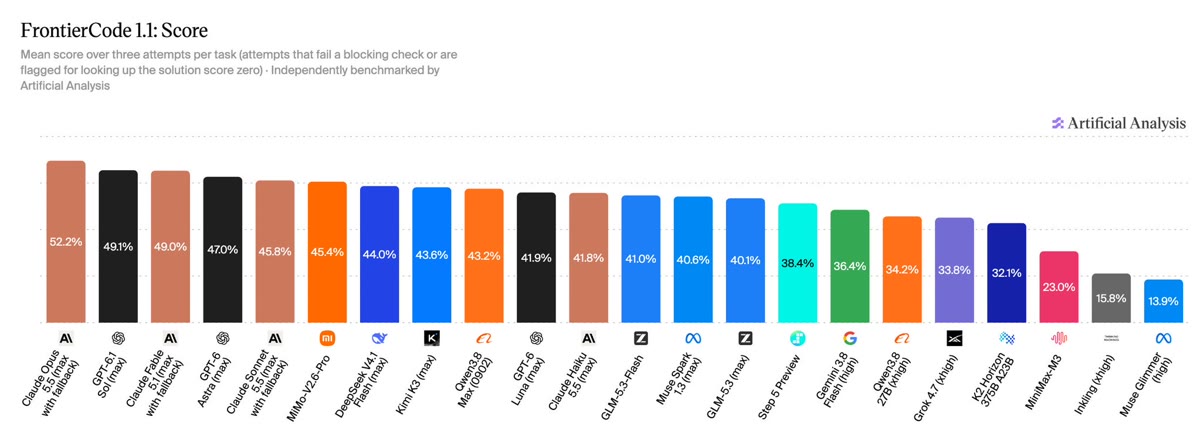
Em 12/10, às 14h51 BRT, a Artificial Analysis lançou seu ranking do FrontierCode 1.1, teste da Cognition com tarefas privadas de projetos reais. Além de verificar se o código funciona, a avaliação penaliza mudanças excessivas, arquivos alterados fora do necessário e testes pouco úteis: a pergunta é se os responsáveis pelo projeto aceitariam a entrega. Segundo a avaliadora, Claude Opus 5.5 lidera com 52%, tendo passado nas exigências obrigatórias em 58% das tentativas. MiMo-V2.6-Pro lidera entre os modelos de pesos abertos, que podem ser baixados, com 45%. GPT-6.1 Sol alcança 49% a $0.81 por tarefa nesse teste. Esses custos são resultados da avaliação, não preços de assinatura. A metodologia completa não foi confirmada na página oficial.
Post âncora
CONFIRMADOOFICIAL Artificial Analysis — responsável pela avaliação
Artificial Analysis lança ranking do FrontierCode 1.1
@ArtificialAnlys ·
O teste avalia código que os responsáveis por projetos reais aceitariam incorporar, além de conferir se funciona. Claude Opus 5.5 lidera com 52%; GPT-6.1 Sol obtém 49% a $0.81 por tarefa.
Estamos lançando nosso ranking do FrontierCode 1.1, uma avaliação privada da Cognition que testa modelos na conclusão de tarefas de programação de uma maneira que realmente seria aceita pelos mantenedores de repositórios do mundo real
@cognition anunciou FrontierCode em junho de 2026 e o atualizou para a versão 1.1 em julho. A Cognition construiu o conjunto de dados com mantenedores de código aberto que dedicaram mais de 40 horas por tarefa. Cada tarefa exige que o agente faça uma mudança em um repositório real de código aberto e então verifica tanto testes unitários quanto testes qualitativos do que os mantenedores exigiriam para incorporar a mudança.
Executamos FrontierCode 1.1 Main, o conjunto principal de 100 tarefas das 150 tarefas do benchmark, usando nosso harness de referência de código aberto Stirrup para comparações em condições equivalentes entre modelos. Todas as tarefas são privadas para evitar contaminação. Cada tentativa é avaliada com critérios obrigatórios e não obrigatórios. Uma tentativa que falha em qualquer verificação obrigatória recebe zero, e uma que passa em todas recebe entre 70% e 100%.
Diferentemente de outras avaliações de programação, FrontierCode tem uma visão mais abrangente do sucesso baseada no uso real. Os modelos precisam passar nos testes unitários, mas também são avaliados por comportamentos como fazer mudanças excessivas e grandes diferenças de código, modificar arquivos fora do escopo relevante ou adicionar testes pouco úteis. Achamos essa abordagem valiosa no contexto atual: os modelos agora são muito capazes em tarefas de programação, mas suas mudanças ainda podem exigir uma limpeza substancial antes que um mantenedor as aceite.
Principais conclusões:
➤ Os modelos líderes ainda falham em mais de 40% das vezes: Claude Opus 5.5 (max with fallback) lidera com uma pontuação de 52% depois de passar nas exigências obrigatórias em 58% de suas tentativas. Nove das 100 tarefas não foram resolvidas em nenhuma tentativa por nenhum dos modelos que avaliamos para o lançamento
➤ O topo do ranking está bastante próximo: nove modelos de seis laboratórios pontuam entre 43% e 52%. MiMo-V2.6-Pro é o modelo de pesos abertos líder com 45%, seguido por DeepSeek V4.1 Flash (max) e Kimi K3 (max) com 44%
➤ GPT-6.1 Sol (max) oferece o desempenho mais forte pelo custo: a $0.81 por tarefa, pontua 49%, igualando Claude Fable 5.1 (max with fallback). Isso significa que alcança desempenho semelhante ao dos principais modelos da Anthropic por menos de um décimo do custo por tarefa
Obrigado a @silasalberti, @ybenpan, @cl571128 e ao restante da equipe da Cognition por construírem FrontierCode e colaborarem conosco para trazê-lo à Artificial Analysis — estamos trabalhando para adicionar FrontierCode ao nosso ranking de agentes de programação muito em breve.
Ver original (texto do post como foi publicado)
We're launching our leaderboard for FrontierCode 1.1, a private evaluation from Cognition that tests models on completing coding tasks in a way that would actually get merged by maintainers of real-world repositories
@cognition announced FrontierCode in June 2026 and updated it to version 1.1 in July. Cognition built the dataset with open source maintainers who spent more than 40 hours per task. Each task requires the agent to make a change to a real open source repository, then checks both unit tests and qualitative tests for what maintainers would require to merge the change.
We run FrontierCode 1.1 Main, the primary 100-task set of the benchmark's 150 tasks, using our Stirrup open source reference harness for apples-to-apples comparisons across models. All tasks are private to avoid contamination. Each attempt is graded with both blocking and non-blocking criteria. An attempt that fails any blocking check scores zero, and one that passes them all scores between 70% and 100%.
Unlike other coding evaluations, FrontierCode has a more holistic view of success based on real usage. Models need to pass unit tests, but are also assessed on behaviors like making excessive changes and large diffs, modifying files outside the relevant scope, or adding unhelpful tests. We think this approach is valuable in the current context: models are now very capable at coding tasks, but their changes can still require substantial cleanup before a maintainer would merge them.
Key takeaways:
➤ Leading models still fail more than 40% of the time: Claude Opus 5.5 (max with fallback) leads at a score of 52% after passing blockers in 58% of its attempts. Nine of the 100 tasks were not passed in any attempt by any of the models we evaluated for launch
➤ The top of the leaderboard is tightly packed: nine models from six labs score between 43% and 52%. MiMo-V2.6-Pro is the leading open weights model at 45%, followed by DeepSeek V4.1 Flash (max) and Kimi K3 (max) at 44%
➤ GPT-6.1 Sol (max) offers the strongest performance for its cost: At $0.81 per task it scores 49%, matching Claude Fable 5.1 (max with fallback). This means it achieves similar performance to leading Anthropic models, at less than a tenth of the cost per task
Thank you to @silasalberti, @ybenpan, @cl571128, and the rest of the team at Cognition for building FrontierCode and collaborating with us to bring it to Artificial Analysis - we’re working to add FrontierCode to our coding agent leaderboard very soon.