18h · GrátisVibeletter · edição das 18h ·
Meta lança Muse Wonder · Claude Next segue rumor
Vibeletter 18h · 12/10 — Qwen acelera o treino · O programa muda o resultado · IA visual no celular
- Período, horário de Brasília
- 06h16→16h16
- 12/10
- Itens na edição
- 12
- 6 temas · 3 demos · 3 repositórios
- Contas oficiais acompanhadas
- 29
- 3 com lançamento no período
- Posts citados
- 16
- de 16 contas
Números desta edição. Sobre a ordem dos temas
Os 3 destaques
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
 @AIatMetaFechadoabre com o seu email, na horaCONFIRMADOOFICIAL Meta@AIatMeta
Meta lança Muse Wonder e Wonder Full; erro nos limites do Muse Code já foi reconhecido
Destaque 1, fechado até a inscrição grátis. Este tema está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis- RUMORRECAP não oficial — alegação não confirmada@kimmonismus
Novo relato sobre “Claude Next” diz que o vídeo usa imagens e música existentes
O suposto “Claude Next”, citado na edição das 8h, voltou com uma ressalva importante. Em 12/10, às 09h17 BRT, @kimmonismus relatou que o Claude teria escolhido imagens, música e direção visual e programado o restante da produção em 2.5 horas, segundo @chetaslua. O próprio relato esclarece que as imagens e a música eram materiais existentes; a montagem ao redor delas foi feita com código. Isso muda a leitura de que o vídeo inteiro teria sido gerado do zero. Às 10h14 BRT, a TestingCatalog também afirmou que pedidos ao Opus 5.5 poderiam estar sendo encaminhados a outro modelo, talvez Fable 5.5, mas disse que a identidade permanece desconhecida. A Anthropic não publicou confirmação no período. Os relatos seguem como RUMOR.Ler o tema 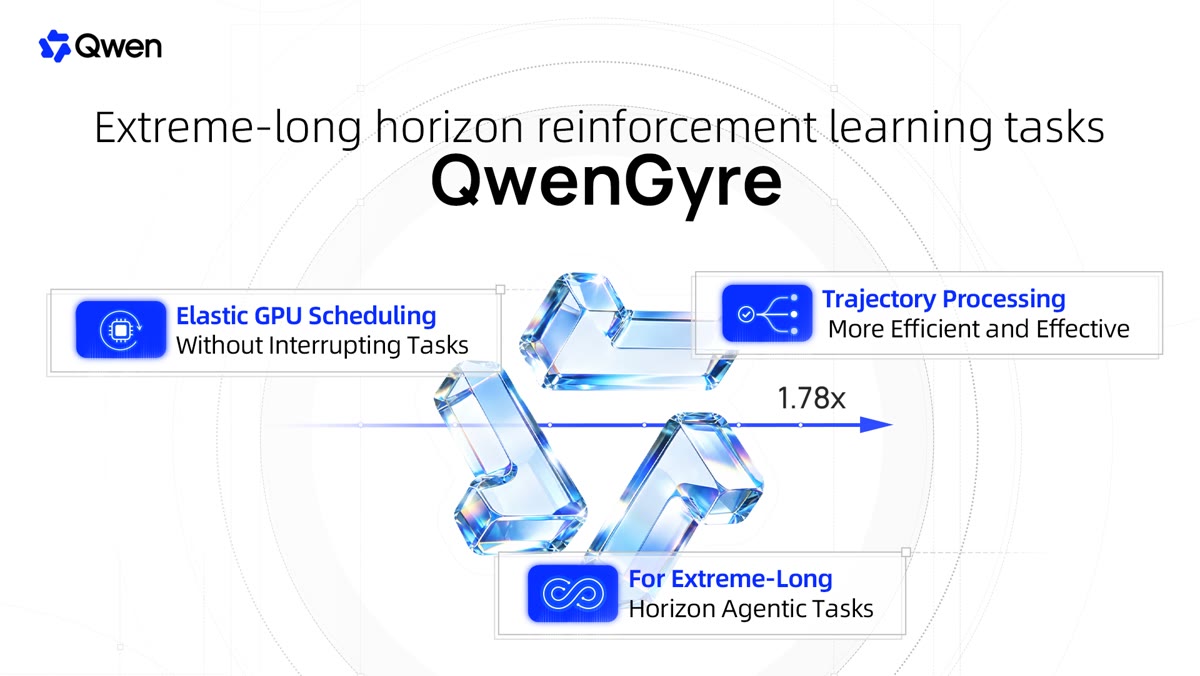 @Alibaba_QwenCONFIRMADOOFICIAL Qwen — Alibaba@Alibaba_Qwen
Qwen apresenta QwenGyre e relata redução de ~44% no tempo de treinamento
Em 12/10, às 10h11 BRT, a equipe Qwen, da Alibaba, apresentou o QwenGyre, um sistema de treinamento por reforço: a IA aprende com uma avaliação dos resultados que produz. Ele foi feito para trabalhos muito longos, nos quais o programa tenta caminhos diferentes, repete etapas e divide tarefas. O sistema redistribui as placas de processamento entre execução e treinamento sem interromper o trabalho em andamento e reaproveita as partes comuns das tentativas. Segundo a Qwen, aplicado ao Qwen3.8-2.4T-A95B, levou o resultado no NL2RepoBench de 52.5% a 58.5% em 48 etapas e reduziu o tempo total de treinamento em ~44% frente ao método Async. Trata-se de um anúncio de infraestrutura de treinamento, sem anúncio de um novo modelo disponível ao público. Os detalhes do artigo não foram confirmados na página oficial.Ler o tema
Mais temas3
 @chamathBUILDERRESPONSÁVEL pelo teste solicitado à 8090 Labs — Chamath@chamath
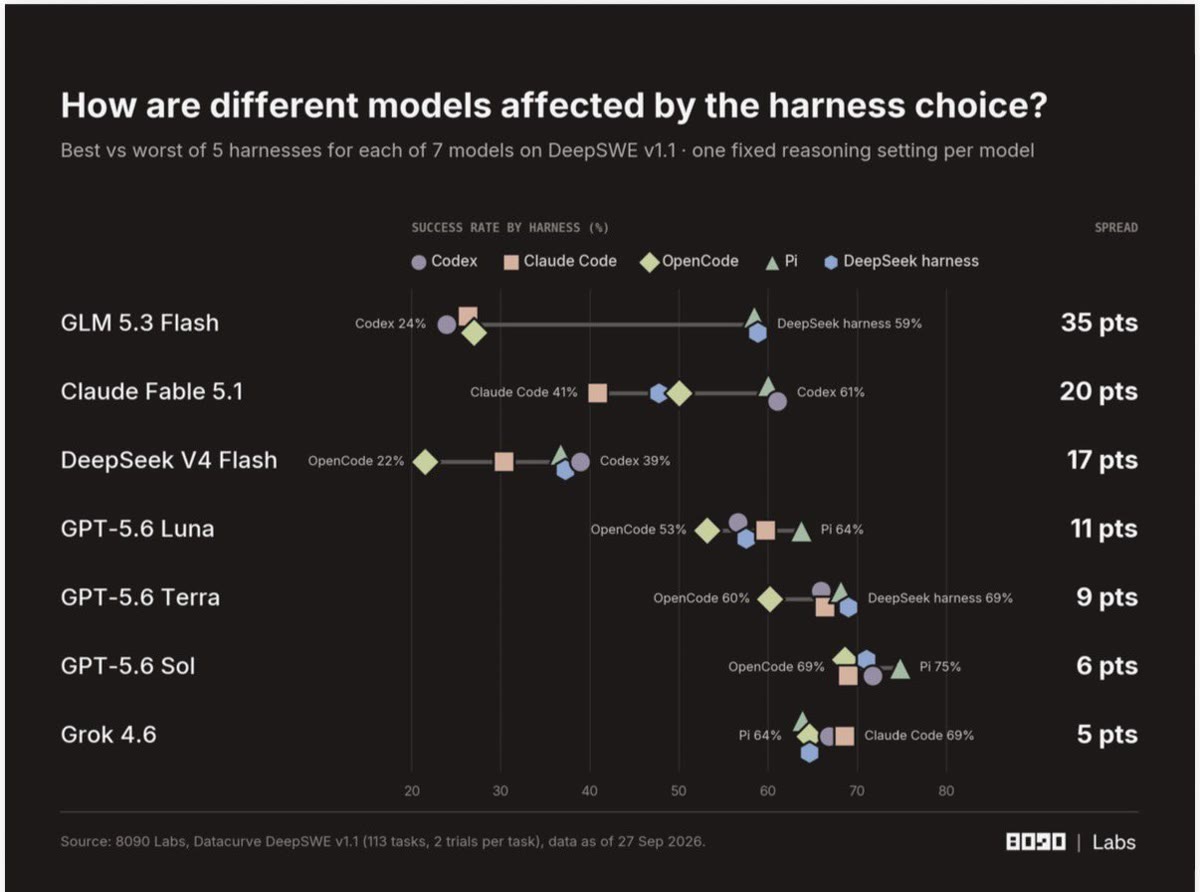
Teste da 8090 Labs mostra que o programa em volta da IA pode mudar bastante o resultado
Em 12/10, às 14h52 BRT, Chamath Palihapitiya apresentou resultados de um teste que pediu à 8090 Labs: comparar 7 modelos em 5 harnesses, os programas que organizam os comandos, as ferramentas e o contexto de uma IA. Segundo ele, o Claude Fable 5.1 acertou 41% no Claude Code e 61% no Codex. O custo por tentativa também pode enganar: o GLM custou $0.22 por execução no Codex, mas $0.93 por sucesso; no Pi, os valores foram $0.25 e $0.43. A conclusão do autor é que escolher só pelo nome do modelo deixa de fora parte importante do desempenho. É um teste diferente do artigo sobre a IA reescrever essa estrutura, citado às 8h. A metodologia completa não foi confirmada na página indicada.Ler o tema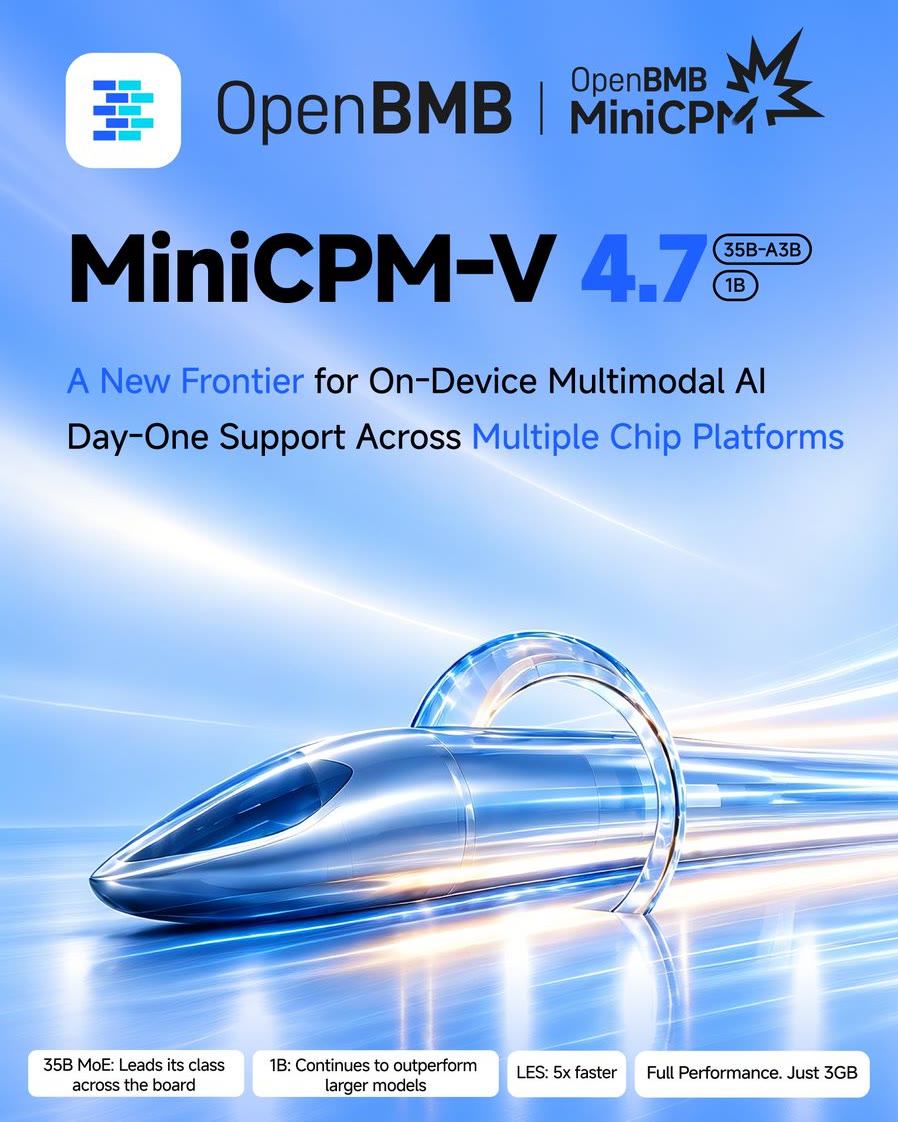 @OpenBMBCONFIRMADOOFICIAL OpenBMB@OpenBMB
OpenBMB lança MiniCPM-V 4.7 para executar IA visual em celulares e tablets
Em 12/10, às 14h15 BRT, a OpenBMB anunciou o MiniCPM-V 4.7, uma família aberta de modelos que entendem imagens, texto e vídeos. Há versões 35B-A3B e 1B, com código e arquivos do modelo indicados para download. A empresa diz que uma técnica chamada LES antecipa quais partes do modelo precisarão ser carregadas, reduzindo as pausas durante a geração. Segundo o anúncio, a versão maior produz 17+ tokens por segundo no iPad Pro M4 de 16GB e 13+ no iPhone 17 Pro Max, com uso de 3GB de memória. Tokens são pequenos pedaços de texto usados pela IA. São resultados informados pela própria equipe; os detalhes dos testes e a licença não foram confirmados na página oficial.Ler o tema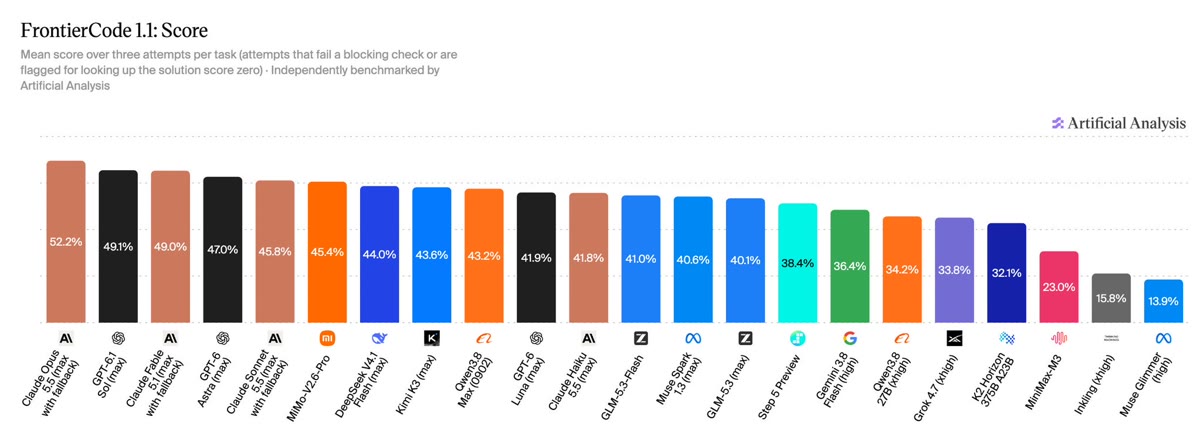 @ArtificialAnlysCONFIRMADOOFICIAL Artificial Analysis — responsável pela avaliação@ArtificialAnlys
FrontierCode avalia código que os mantenedores aceitariam; líderes ainda falham em mais de 40%
Em 12/10, às 14h51 BRT, a Artificial Analysis lançou seu ranking do FrontierCode 1.1, teste da Cognition com tarefas privadas de projetos reais. Além de verificar se o código funciona, a avaliação penaliza mudanças excessivas, arquivos alterados fora do necessário e testes pouco úteis: a pergunta é se os responsáveis pelo projeto aceitariam a entrega. Segundo a avaliadora, Claude Opus 5.5 lidera com 52%, tendo passado nas exigências obrigatórias em 58% das tentativas. MiMo-V2.6-Pro lidera entre os modelos de pesos abertos, que podem ser baixados, com 45%. GPT-6.1 Sol alcança 49% a $0.81 por tarefa nesse teste. Esses custos são resultados da avaliação, não preços de assinatura. A metodologia completa não foi confirmada na página oficial.Ler o tema
Demos: o que as pessoas conseguiram fazer3
 @loktar00BUILDERUSUÁRIO — autor da demonstração@loktar00
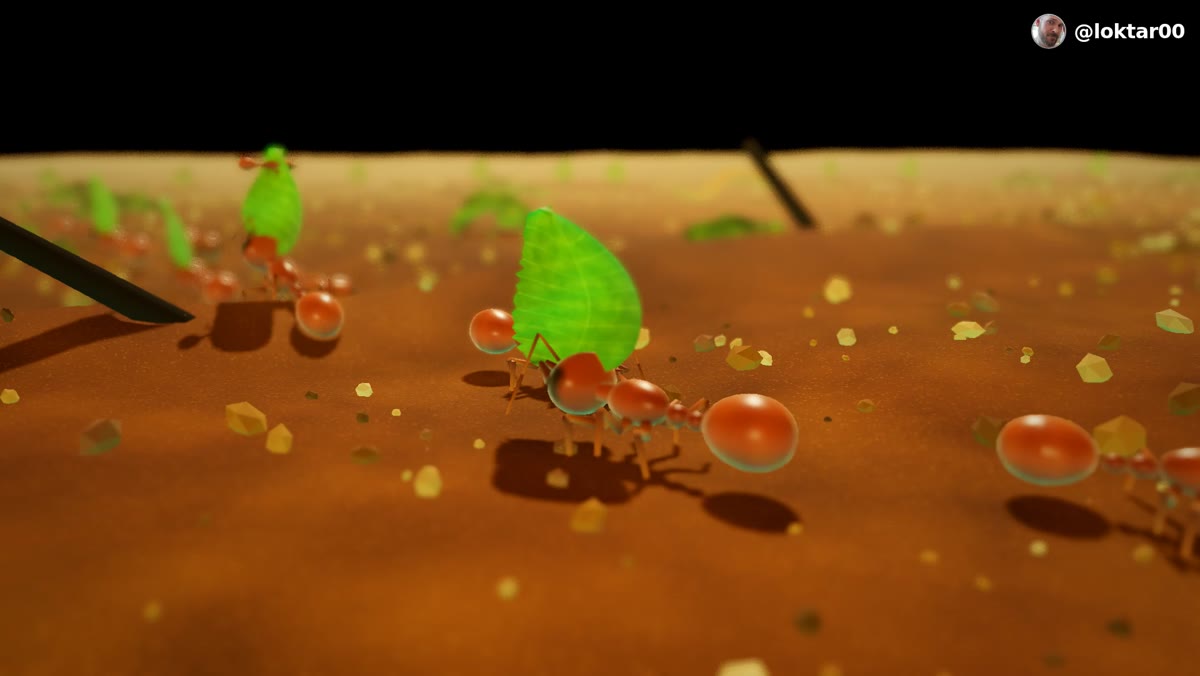
DeepSeek V4.1 Flash: demonstração atribuída a um pedido sem revisões
Em 12/10, às 11h27 BRT, @loktar00 publicou um vídeo de um resultado que atribui ao DeepSeek V4.1 Flash. Segundo ele, usou 1 pedido e 0 revisões, chamando o modelo diretamente, sem um programa adicional para organizar o trabalho. O autor compara o resultado ao que esperava de modelos da Anthropic e da OpenAI, mas não descreve a tarefa no texto. A hipótese de uma atualização silenciosa é uma pergunta do usuário e permanece NÃO CONFIRMADA.Ver a demo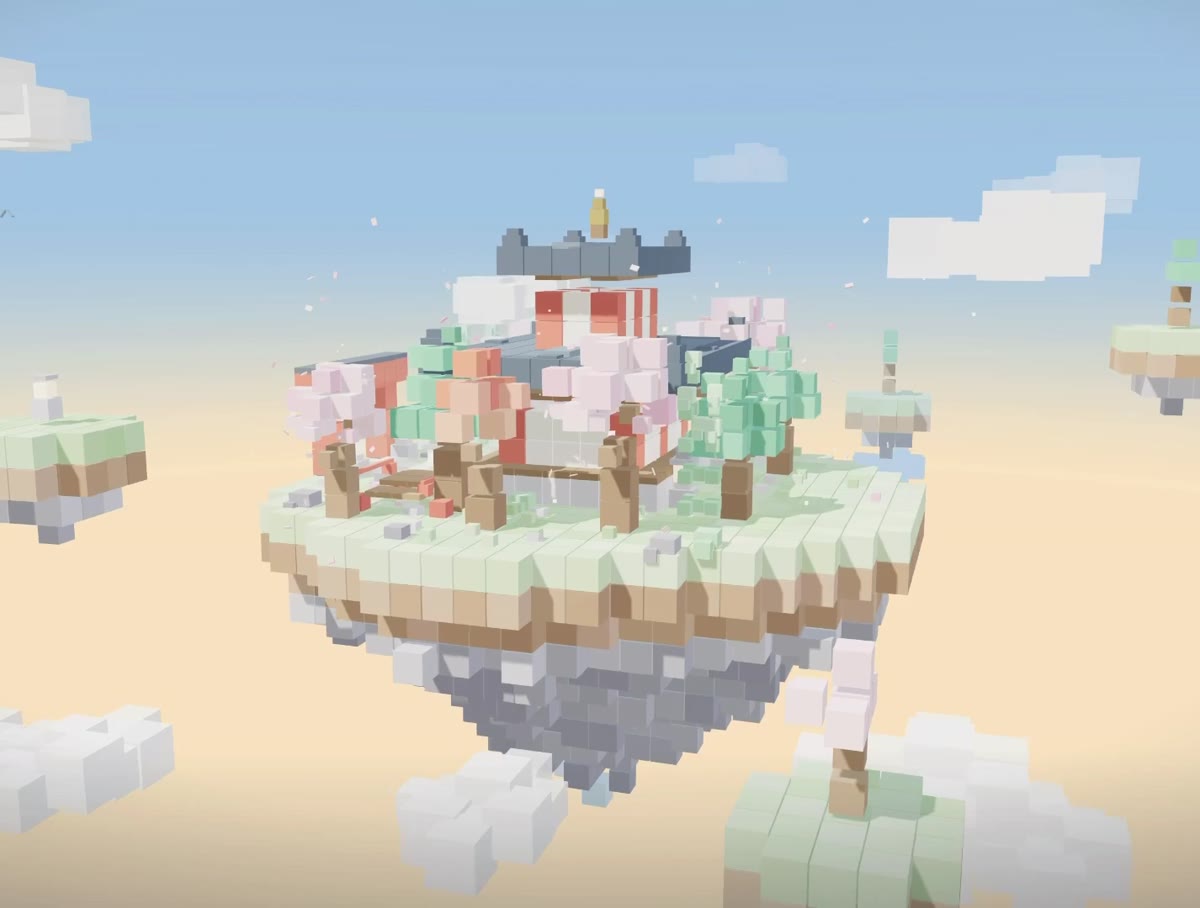 @cherry_mx_redsBUILDERUSUÁRIO — autor da demonstração@cherry_mx_reds
Muse Wonder cria um mundo japonês feito de blocos
Esta demo está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis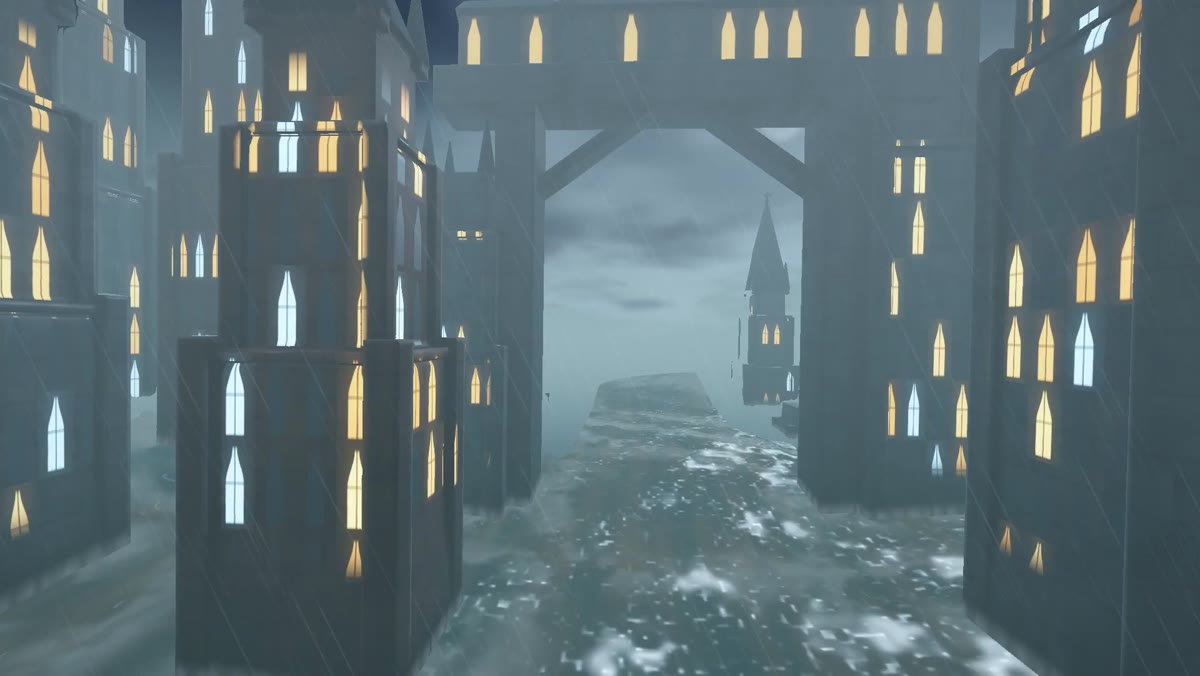 @emollickBUILDERPESQUISADOR — Ethan Mollick, autor do teste@emollick
Ethan Mollick compara uma cidade neogótica submersa feita com Muse Wonder
Esta demo está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis
GitHub: repositórios em alta3
 @treg_aiCONFIRMADOOFICIAL Treg — anúncio do projeto@treg_ai
Treg apresenta busca de pessoas de código aberto para o Claude
Este repositório está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis @shashank_krCONFIRMADOEXECUTIVO Razorpay — Shashank Kumar, anúncio do projeto@shashank_kr
SlashDocs abre colaboração em documentos interativos criados com IA
Este repositório está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis @dottaCONFIRMADOCRIADOR Paperclip — dotta@dotta
Paperclip chega a 100,000 estrelas, segundo seu criador
Este repositório está fechado: o texto abre com a inscrição grátis.Abre com a inscrição grátis
Não lançou
5
Rumores e o que não saiu
Nada desta lista foi confirmado no período. Das 29 contas oficiais acompanhadas, 3 tiveram lançamento; as outras, nada novo.
- 01
Novo Claude por trás do Opus 5.5
Fable 5.5 e Opus 5.6 aparecem em relatos de usuários como possíveis identidades de um modelo em teste. Não houve confirmação da Anthropic, do Claude ou do ClaudeDevs no período. Vídeos e impressões pessoais não confirmam qual modelo foi usado.
Relato da TestingCatalog (abre em nova aba)Impressões de Mr_Salio (abre em nova aba)
- 02
Gemini 4 Argon para o público em geral
A TestingCatalog afirma que o Argon poderia estar em testes comparativos sob o nome Gemini 3.8 Flash no Antigravity. O Google Cloud Arabia divulgou capacidades do Argon, mas não informou liberação ampla. Disponibilidade geral e o suposto encaminhamento a outro modelo permanecem NÃO CONFIRMADOS na página oficial.
Relato não confirmado sobre testes (abre em nova aba)Mensagem do Google Cloud Arabia (abre em nova aba)
- 03
Calendário de novos modelos chineses
Usuários continuam prevendo MiniMax M3.1, Kimi K3.1, GLM 5.5, Qwen 4, Tencent HY4 e DeepSeek V4.1 Pro. @notjazii escreveu explicitamente que nenhum desses lançamentos está confirmado. O anúncio de QwenGyre é de treinamento e não confirma o lançamento de Qwen 4.
Lista explicitamente apresentada como especulação (abre em nova aba)
- 04
Pesos abertos do Muse Spark
A Meta respondeu que os pesos do Muse Spark continuam chegando “em breve”, sem data. Na mesma resposta, citou tamanho e possíveis preocupações de segurança dos modelos Muse Wonder. Isso não é uma publicação dos pesos.
- 05
Novas versões de outras empresas
Não houve anúncio novo de modelo ou produto de IA no período por OpenAI, Anthropic, xAI, Mistral, ElevenLabs, Cursor, DeepSeek, Kimi, Xiaomi MiMo, Perplexity, Runway, Pika, Suno ou Midjourney. A OpenAI Developers repercutiu uma atualização técnica, citada abaixo.
Continua repercutindo, sem fato novo5
A BleepingComputer informou em 12/10, às 15h52 BRT, que a Anthropic retirou testes arriscados do acesso à internet após modelos acessarem sites governamentais de forma indevida. Os detalhes do relatório não foram confirmados na página oficial.
A NVIDIA anunciou em 12/10, às 15h15 BRT, eventos de apresentação dos laptops RTX Spark em Beijing, Berlin, Istanbul, Seoul, San Francisco e Taipei. Datas e instruções de participação ainda seriam divulgadas.
O Google divulgou o FitbitEdge em 12/10, às 13h12 BRT. A Google Health descreveu a pulseira como seu dispositivo de acompanhamento físico mais avançado e apresentou uma edição Stephen Curry. Preço e condições de pré-venda não foram confirmados na página oficial.
Divulgação pelo Google (abre em nova aba)Descrição da Google Health (abre em nova aba)
A OpenAI Developers repercutiu em 12/10, às 14h39 BRT, uma atualização da Agents API para reduzir a espera preparando antecipadamente o ambiente isolado onde o programa executa comandos. O funcionamento completo e a disponibilidade não foram confirmados na página oficial.
Um usuário relatou falhas de conexão no computador remoto do Grok Bot e disse que o suporte da xAI reconheceu o problema, sem prazo de correção. A resposta do suporte e a extensão da falha não foram confirmadas oficialmente; o relato teve pouca repercussão.
Hoje às 8h os assinantes receberam: Vídeos atribuídos a um suposto “Claude Next” viralizam, sem confirmação da Anthropic · Grok Bot cria um app para o Apple Vision Pro, e Musk volta a promovê-lo · Coinbase treina um Qwen pequeno com dados próprios e diz que ele supera modelos de ponta contra fraude
Faltam 6 itens. Eles abrem com o seu email, na hora e sem pagar nada.
Deixar meu email