04 · Tema 4 de 7 · máx. 61,1k views morno (calor 2 de 5; máx. 61,1k views)
Liquid AI lança LFM2.5-24B-A2B com pesos abertos para tarefas locais
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
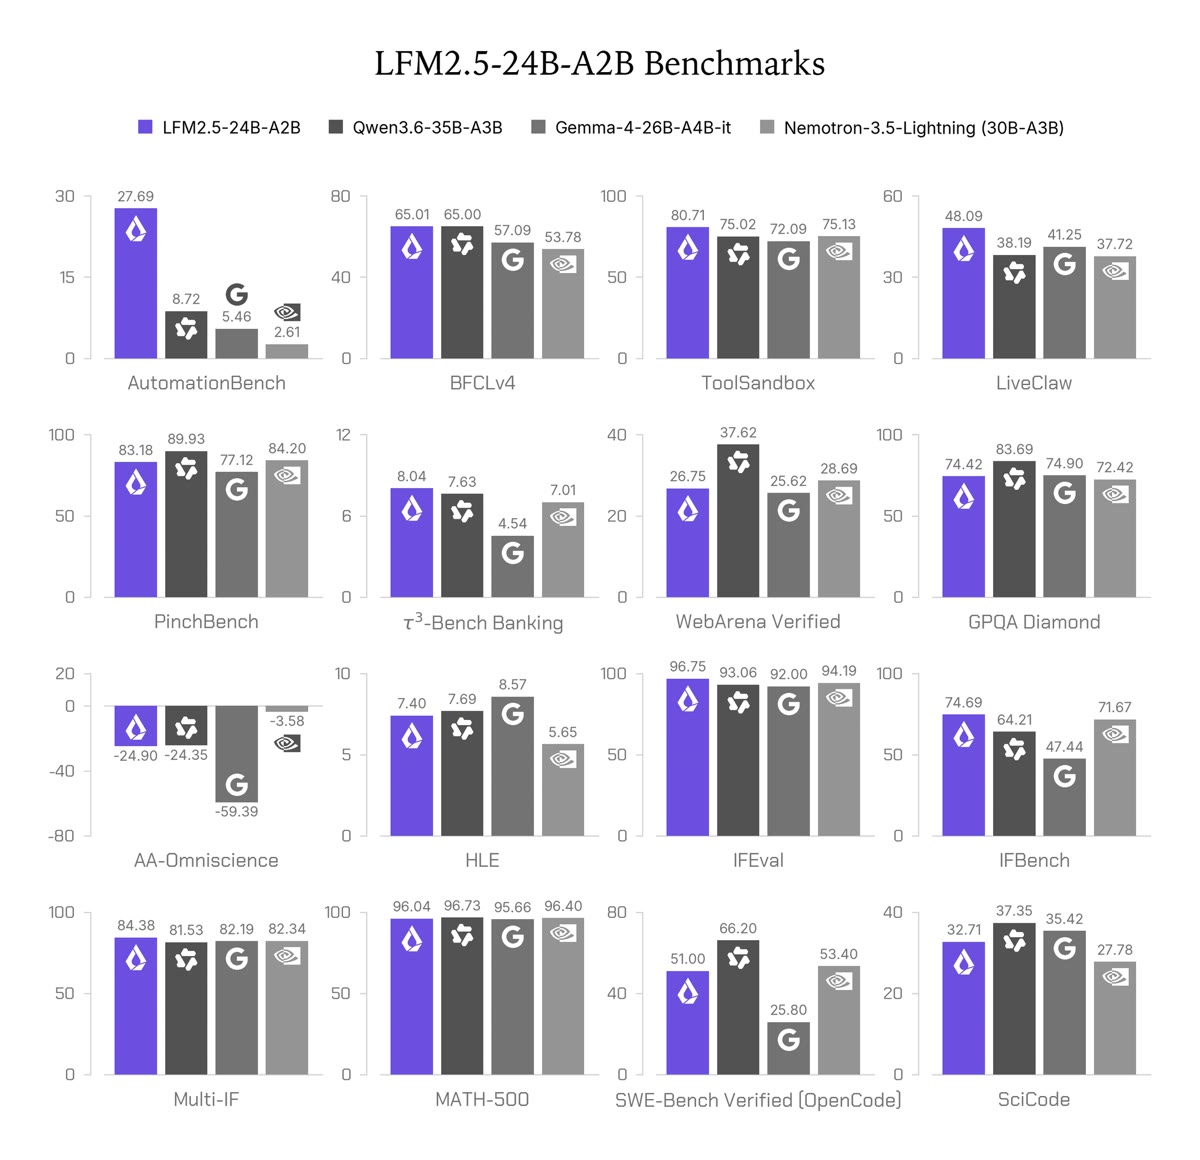
Em 13/10, às 14h11 BRT, a Liquid AI lançou o LFM2.5-24B-A2B, apresentado como um modelo para executar tarefas de várias etapas em laptops e PCs. Ele tem 24B parâmetros, os valores internos que definem seu funcionamento, mas ativa 2B ao processar cada unidade de texto. A empresa informa capacidade de contexto de 131K tokens, unidades usadas para representar texto, e pesos abertos no Hugging Face. A comparação favorável com Qwen3.6-35B-A3B é uma alegação da própria Liquid AI. Licença e requisitos de memória para execução não foram confirmados na página oficial.
Post âncora
CONFIRMADOOFICIAL Liquid AI
@liquidai
A Liquid AI lança um modelo local com 24B parâmetros totais e 2B ativos por token, cada unidade de texto processada. A empresa informa contexto de 131K tokens e pesos abertos no Hugging Face.
Hoje lançamos 𝙻𝙵𝙼𝟸.𝟻-𝟸𝟺𝙱-𝙰𝟸𝙱, o maior integrante da família 𝙻𝙵𝙼𝟸.𝟻. É um modelo local eficiente para laptops e PCs executarem tarefas de várias etapas dentro de estruturas populares de execução de agentes.
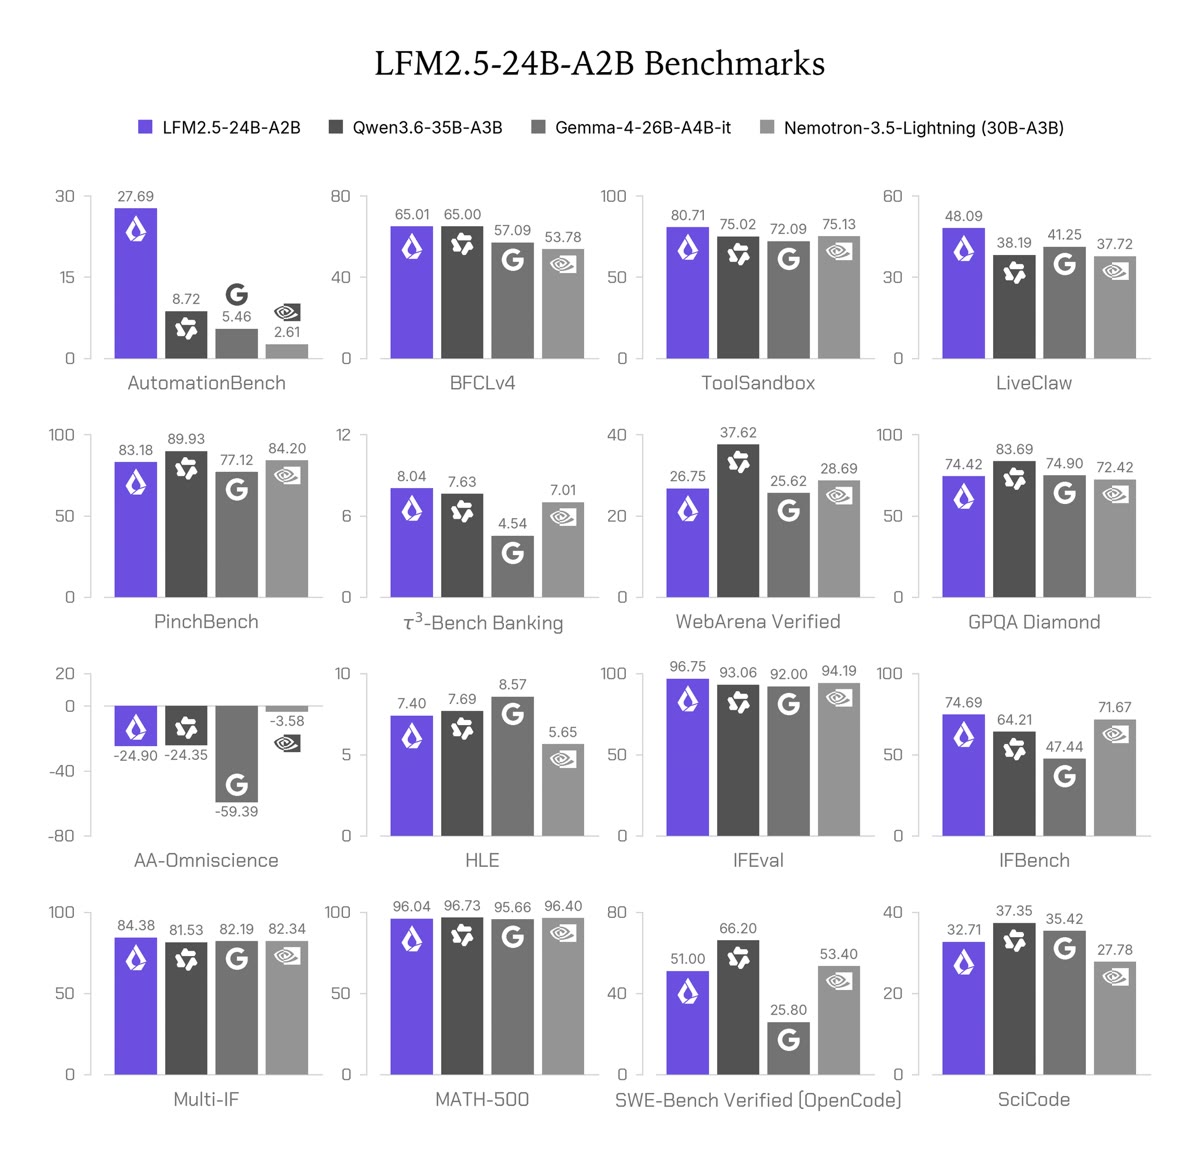
> 24B parâmetros totais, 2B ativos por token > Contexto ampliado para 131K tokens > Um vocabulário de 128K tokens > 33T tokens de pré-treinamento > É um modelo de raciocínio > Muito fácil de ajustar e personalizar > Tem desempenho competitivo com Qwen3.6-35B-A3B, um modelo com ~50% mais parâmetros totais e ativos, em tarefas com agentes e uso de ferramentas. > Pesos abertos da versão base e da versão pós-treinada no @huggingface 🤗
1/
Ver original (texto do post como foi publicado)
Today we release 𝙻𝙵𝙼𝟸.𝟻-𝟸𝟺𝙱-𝙰𝟸𝙱, the largest 𝙻𝙵𝙼𝟸.𝟻 family member. It is an efficient local model for laptops and PCs to work through multi-step tasks inside popular agent harnesses.
> 24B total parameters, 2B active per token > Context expanded to 131K tokens > A 128K-token vocabulary > 33T pretraining tokens > It is a reasoning model > Very easy to fine-tune and customize > Performs competitively with Qwen3.6-35B-A3B, a model with ~50% more total and active parameters, on agentic and tool-use tasks. > Open base and post-trained weights on @huggingface 🤗
1/