05 · Tema 5 de 7 · máx. 35,5k views morno (calor 2 de 5; máx. 35,5k views)
Novos testes do Muse mostram resultados diferentes entre versões e avaliações
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
O que é novo: Novos testes de programação e uma avaliação do BridgeBench, distintos da correção de cotas apresentada às 8h.
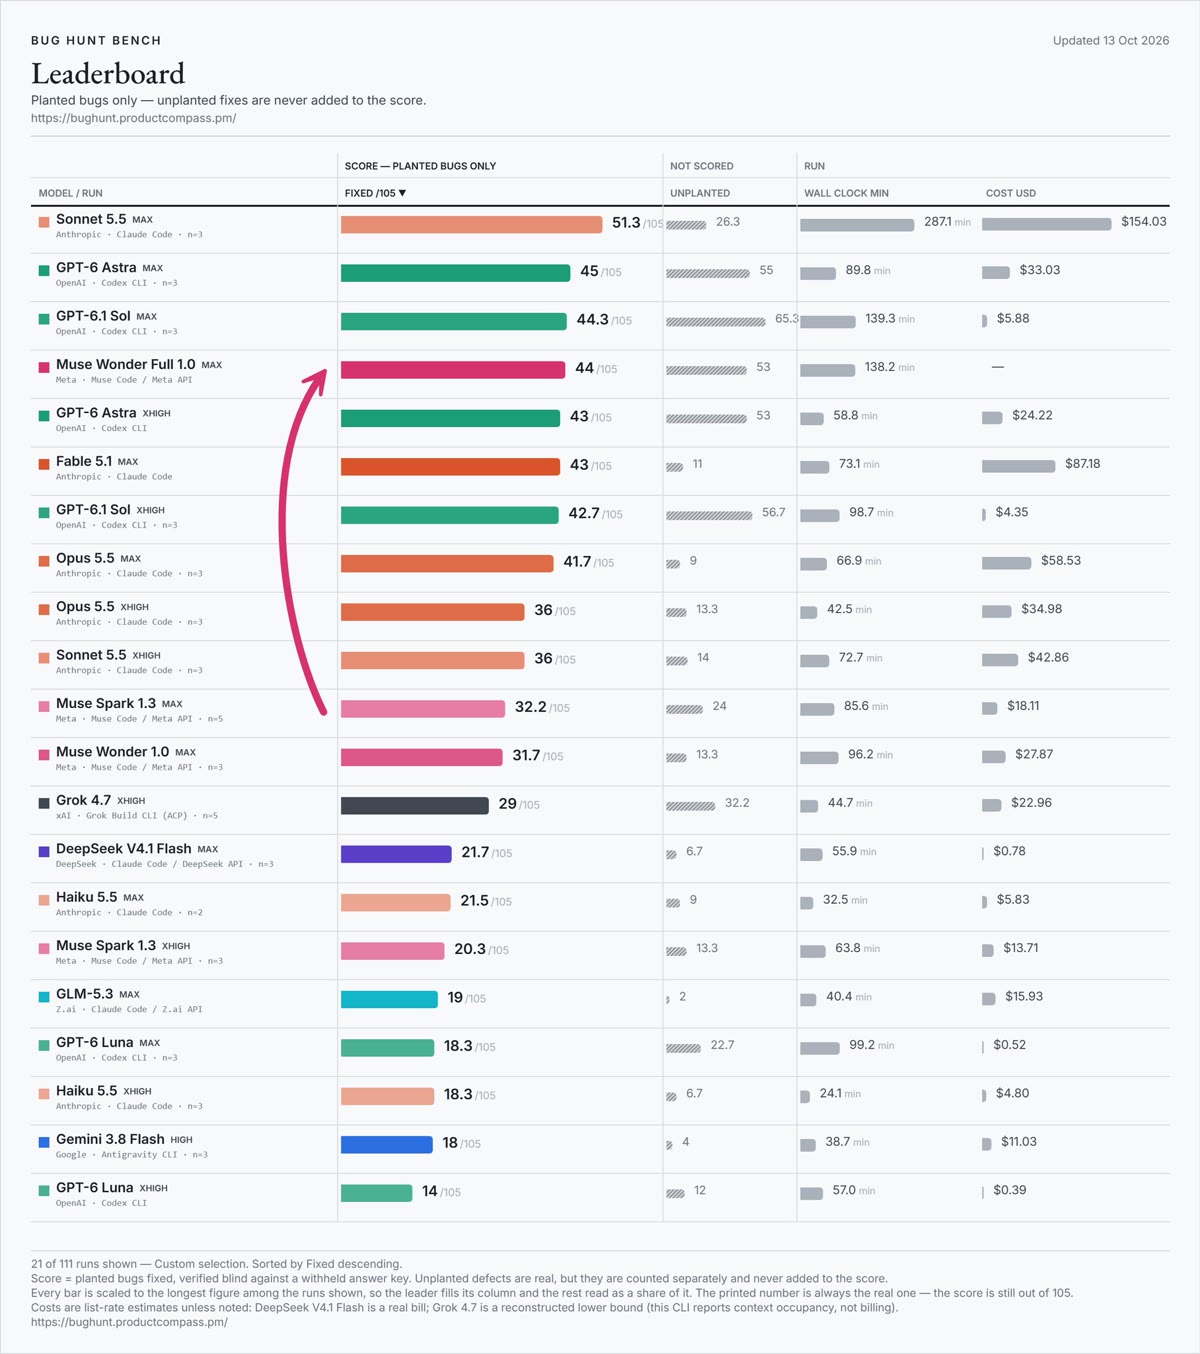
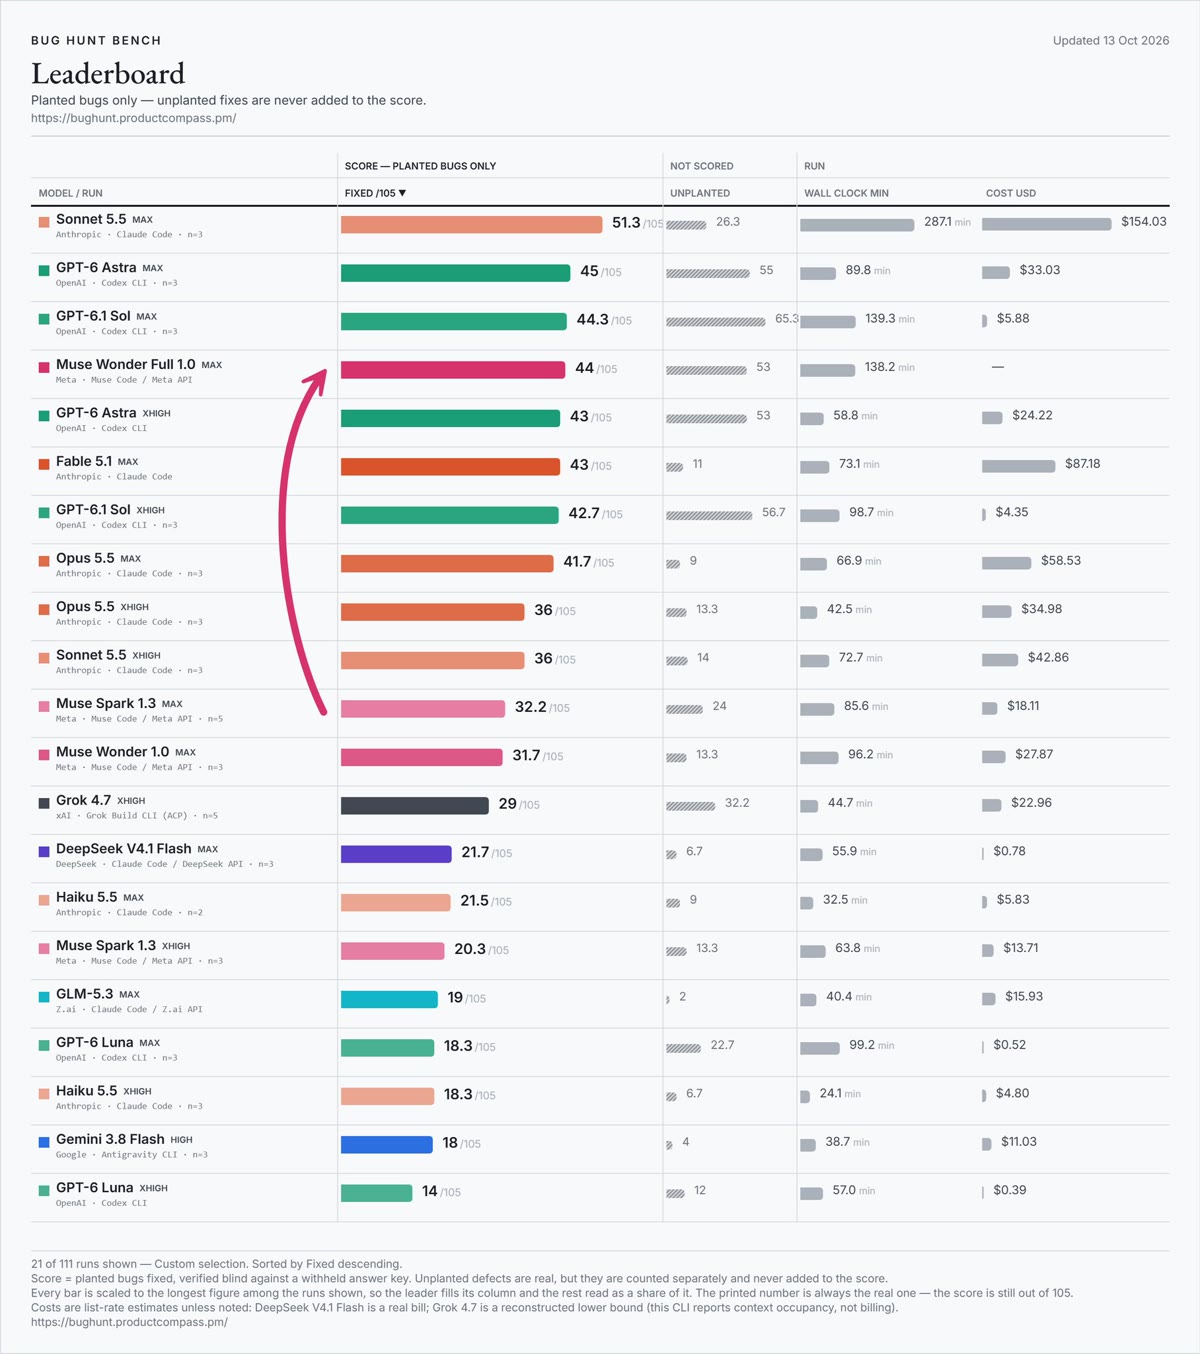
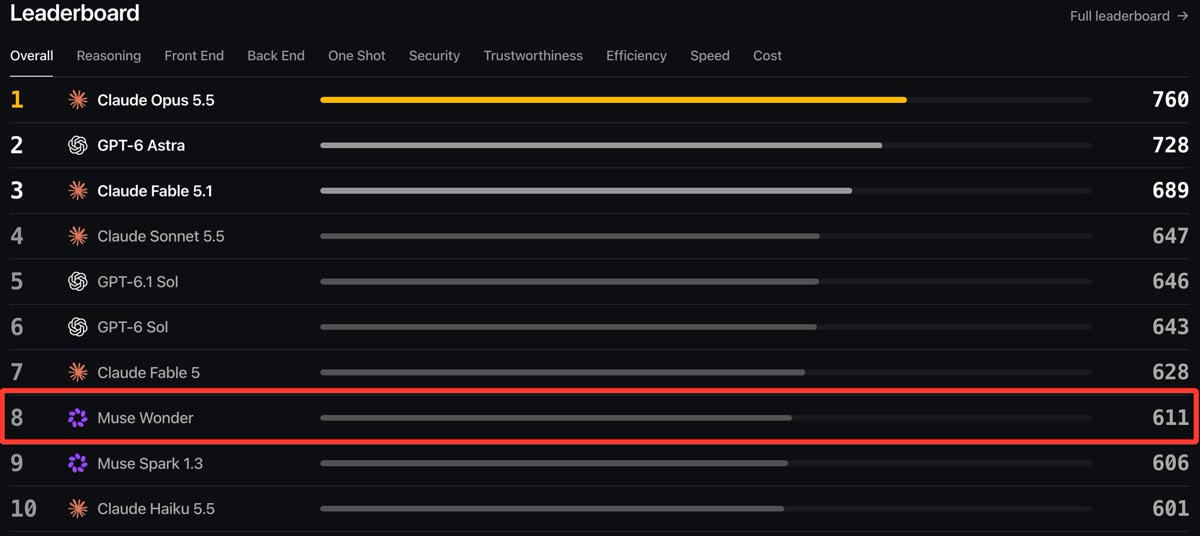
Em 13/10, às 13h34 BRT, Paweł Huryn apresentou um teste do Muse Wonder Full 1.0 com 105 erros em dois repositórios de código. Ele atribuiu 44 ao Muse Wonder Full e 45 ao GPT-6 Astra, mas não explicou no texto curto a unidade de cada resultado. Separadamente, às 09h38 BRT, o BridgeBench publicou 611 para Muse Wonder e 601 para Claude Haiku 5.5 em sua própria avaliação, com uma conclusão crítica sobre o desempenho da Meta. Os nomes das versões e os testes são diferentes; os números não permitem comparar diretamente as duas publicações. A novidade em relação às 8h são essas avaliações, e não outra correção de cotas.
Post âncora
BUILDERUSUÁRIO — Paweł Huryn, autor do teste
Huryn apresenta teste do Muse Wonder Full com 105 erros
@PawelHuryn ·
Paweł Huryn diz ter testado Muse Wonder Full 1.0 com 105 erros em 2 repositórios. Ele publica 44 para Muse Wonder Full e 45 para GPT-6 Astra, sem explicar no texto curto a unidade desses resultados.
Então, testei Muse Wonder Full 1.0 em trabalho real. 2 repositórios. 105 erros que os modelos de ponta não encontraram no Q1 2026. Encontre e corrija o que puder.
Estou tão surpreso que precisamos de uma nova sequência de publicações. Os resultados:
GPT-6 Astra (max): 45 Muse Wonder Full 1.0 (max): 44 Fable 5.1 (max): 43 Opus 5.5 (max): 41.7 Muse Spark 1.3 (max): 32.2 Grok 4.7 (xhigh): 29
@AIatMeta acaba de se igualar à Anthropic e à OpenAI. Meus parabéns!
A seguir nesta sequência, mais níveis de esforço e mais execuções para Muse Wonder Full 1.0. Tudo será publicado nesta noite 🧵
Ver original (texto do post como foi publicado)
So, I tested Muse Wonder Full 1.0 on real work. 2 repos. 105 bugs frontier models missed in Q1 2026. Find and fix what you can.
I'm so surprised we need a new thread. The results:
GPT-6 Astra (max): 45 Muse Wonder Full 1.0 (max): 44 Fable 5.1 (max): 43 Opus 5.5 (max): 41.7 Muse Spark 1.3 (max): 32.2 Grok 4.7 (xhigh): 29
@AIatMeta has just matched Anthropic and OpenAI. Huge congrats!
Next in this thread, more effort levels and more runs for Muse Wonder Full 1.0. All dropping tonight 🧵
Outros posts do tema 1
BUILDERAUTOR da avaliação — BridgeBench
BridgeBench atribui 611 ao Muse Wonder e 601 ao Haiku
@bridgebench ·
O BridgeBench publica 611 para Muse Wonder e 601 para Claude Haiku 5.5 em sua avaliação. O autor interpreta o resultado como insuficiente para colocar a Meta entre os sistemas de ponta.
O novo Muse Wonder da Meta agora está no BridgeBench.
Ele supera por pouco Claude Haiku 5.5. O menor modelo da Anthropic.
Muse Wonder: 611 Claude Haiku 5.5: 601
É apenas 5 pontos melhor que o próprio Muse Spark 1.3 da Meta e fica 149 pontos atrás de Claude Opus 5.5.
A Meta ainda está longe da fronteira.
Ver original (texto do post como foi publicado)
Meta's new Muse Wonder is now on BridgeBench.
It barely beats Claude Haiku 5.5. Anthropic's smallest model.
Muse Wonder: 611 Claude Haiku 5.5: 601
It's only 5 points better than Meta's own Muse Spark 1.3, and 149 points behind Claude Opus 5.5.
Meta is still nowhere near the frontier.