05 · Tema 5 de 7 · máx. 16,9k views frio (calor 1 de 5; máx. 16,9k views)
Gemini lidera por pouco avaliação de interpretação de imagens científicas
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
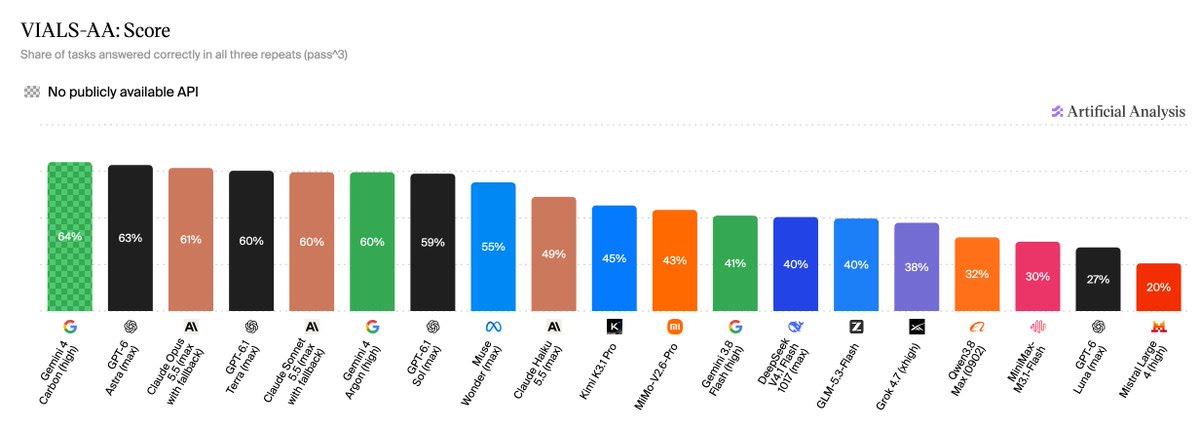
A Artificial Analysis apresentou em 06/11 o VIALS-AA, classificação baseada em 161 tarefas da Handshake AI que exigem interpretar imagens científicas, como mapas de DNA e gráficos de experimentos. Cada tarefa é repetida três vezes, e só conta como acerto quando as três respostas são consideradas corretas; a correção é feita pelo GPT-6 Luna. Nessas condições, Gemini 4 Carbon marcou 64%, GPT-6 Astra, 63%, e Claude Opus 5.5, 61%. O resultado descreve esse teste específico, não uma superioridade geral em pesquisa científica.
Post âncora
BUILDERArtificial Analysis — autora da avaliação
VIALS-AA compara IAs na interpretação de imagens científicas
@ArtificialAnlys ·
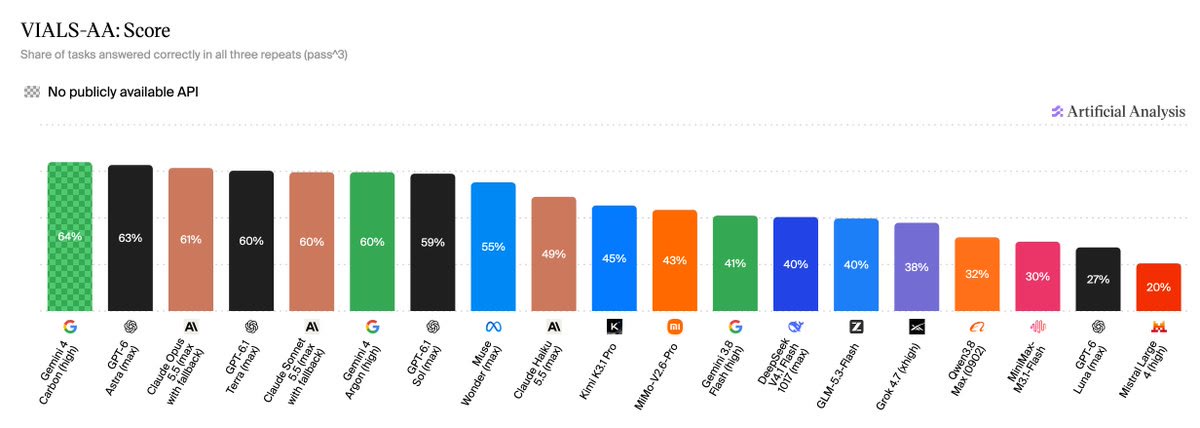
A Artificial Analysis apresenta uma avaliação com 161 tarefas de interpretação de imagens científicas. Gemini 4 Carbon lidera com 64%, seguido por GPT-6 Astra com 63% e Claude Opus 5.5 com 61%, nas condições descritas pelos autores.
Estamos lançando VIALS-AA, uma classificação para a avaliação VIALS da Handshake AI de raciocínio visual em ciências da vida e pesquisa em biotecnologia
Materiais visuais são centrais para a maneira como cientistas analisam experimentos e tomam decisões de pesquisa, mas interpretá-los corretamente continua sendo um desafio para os modelos de ponta. As 161 tarefas do VIALS abrangem oito áreas e exigem que os modelos raciocinem sobre materiais como imagens de géis e blots, gráficos de citometria de fluxo, mapas de plasmídeos e filogenias. Cada tarefa exige que os modelos interpretem um material e cheguem a uma conclusão científica específica.
Avaliamos os modelos executando cada tarefa três vezes no Stirrup, nossa estrutura de execução de agentes de código aberto, com ferramentas de execução de código e inspeção de imagens. GPT-6 Luna (medium) avalia cada resposta em relação à resposta de referência, e informamos a proporção de tarefas consideradas corretas nas três repetições (pass^3).
Principais conclusões:
➤ Os três primeiros modelos estão separados por 3 pontos: Gemini 4 Carbon (high), da @GoogleDeepMind, lidera por pouco com 64%, seguido por GPT-6 Astra (max), da @OpenAI, com 63% e Claude Opus 5.5 (max with fallback), da @AnthropicAI, com 61%
➤ Astra e Sol alcançam pontuações semelhantes às de Opus e Sonnet com um custo por tarefa muito menor: Claude Opus 5.5 (max with fallback) tem média de $1.64 por tarefa, ~29× o valor de Sol (~$0.056). Essa diferença de preço é significativamente influenciada pelo uso de turnos — GPT-6 Astra (max) e GPT-6.1 Sol (max) têm média de ~8 turnos por tarefa, em comparação com ~27 para Claude Opus 5.5 (max with fallback) e ~25 para Claude Sonnet 5.5 (max with fallback)
➤ Modelos de pesos abertos ficam ~19 pontos atrás da maior pontuação: Kimi K3.1 Pro lidera os modelos de pesos abertos no VIALS-AA com 45%, pouco à frente de MiMo-V2.6-Pro com 43%
➤ 14 das 161 tarefas tiveram recusas por segurança em pelo menos um modelo: Claude Sonnet 5.5 (max with fallback) recusou 6 tarefas, o maior número entre todos os modelos, e metade das 14 tarefas afetadas teve recusas de vários modelos
Obrigado à @joinHandshakeAI e aos autores do VIALS por criarem a avaliação e colaborarem conosco para trazê-la à Artificial Analysis!
Ver original (texto do post como foi publicado)
We’re launching VIALS-AA, a leaderboard for Handshake AI’s VIALS benchmark for visual reasoning in life sciences and biotech research
Visual artifacts are central to how scientists analyze experiments and make research decisions, but interpreting them correctly remains a challenge for frontier models. VIALS’ 161 tasks span eight domains and need models to reason over artifacts including gel blots, flow cytometry plots, plasmid maps, and phylogenies. Each task requires models to interpret an artifact and draw a specific scientific conclusion.
We evaluate models by running each task three times in Stirrup, our open source agent harness, with code execution and image inspection tools. GPT-6 Luna (medium) grades each answer against the reference answer, and we report the share of tasks judged correct in all three repeats (pass^3).
Key takeaways:
➤ The top three models are separated by 3 points: Gemini 4 Carbon (high) from @GoogleDeepMind leads narrowly with 64%, followed by GPT-6 Astra (max) from @OpenAI at 63% and Claude Opus 5.5 (max with fallback) from @AnthropicAI at 61%
➤ Astra and Sol achieve similar scores to Opus and Sonnet at a much lower Cost per Task: Claude Opus 5.5 (max with fallback) averages $1.64 per task, ~29× as much as Sol (~$0.056). This price difference is significantly driven by turn use - GPT-6 Astra (max) and GPT-6.1 Sol (max) average ~8 turns per task, compared with ~27 for Claude Opus 5.5 (max with fallback) and ~25 for Claude Sonnet 5.5 (max with fallback)
➤ Open weights models trail the highest score by ~19 points: Kimi K3.1 Pro leads open weights models on VIALS-AA at 45%, narrowly ahead of MiMo-V2.6-Pro at 43%
➤ 14 of 161 tasks saw safety refusals on at least one model: Claude Sonnet 5.5 (max with fallback) refused on 6 tasks, the most of any model, and half of the 14 affected tasks saw refusals from multiple models
Thank you to @joinHandshakeAI and the VIALS authors for creating the benchmark and collaborating with us on bringing it to Artificial Analysis!