04 · Tema 4 de 7 · máx. 45k views morno (calor 2 de 5; máx. 45k views)
OpenAI apresenta BioBasicsBench para testar tarefas reais de laboratório
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
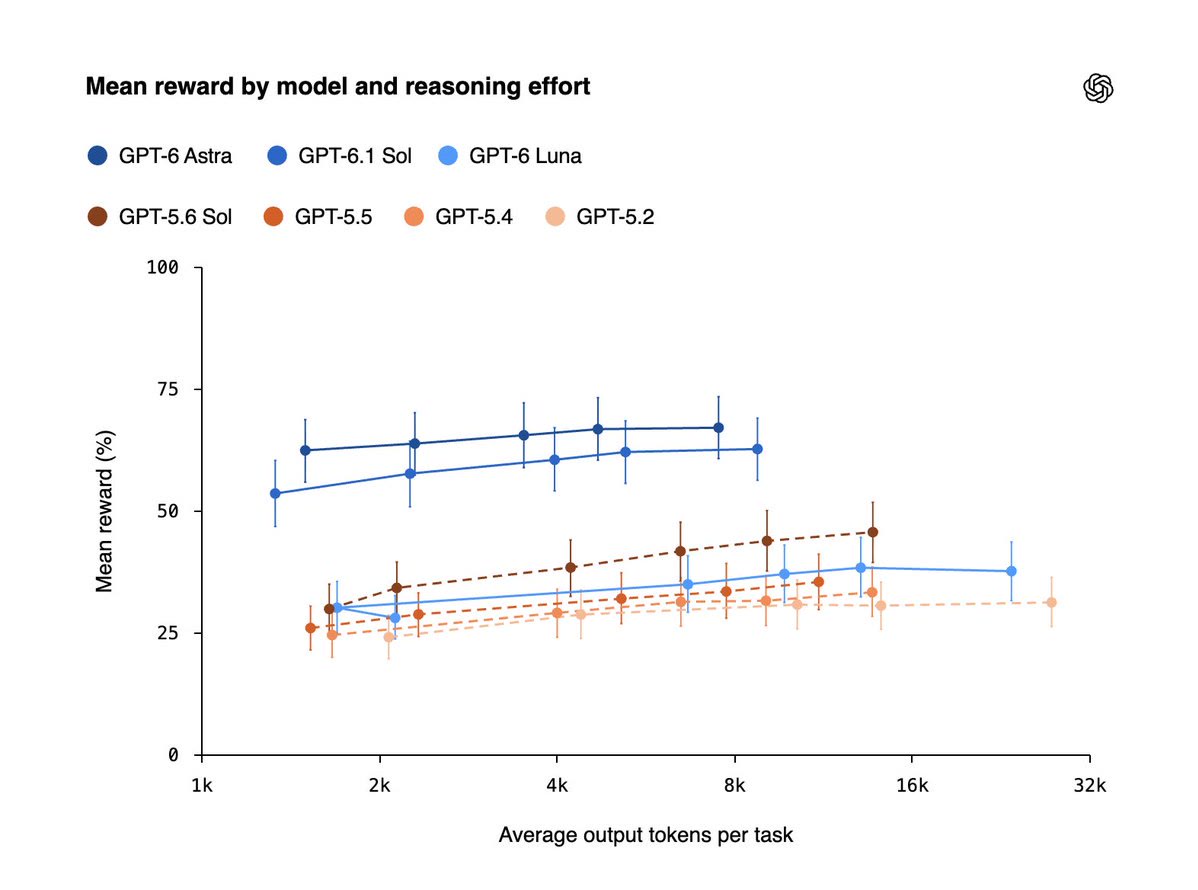
A OpenAI apresentou em 06/11, às 16h08 BRT, o BioBasicsBench, uma avaliação criada com a Ligo, empresa de biotecnologia dedicada ao desenvolvimento de enzimas. O teste reúne 100 tarefas de experimentos reais para verificar se assistentes de IA conseguem interpretar dados brutos de laboratório, identificar erros e reconhecer quando não há evidência suficiente para uma conclusão. A publicação apresenta o objetivo da avaliação, sem divulgar uma tabela de resultados. Trata-se de um novo teste de capacidades, não de uma nova versão do GPT.
Fonte oficialApresentação indicada pela OpenAI (abre em nova aba)
Post âncora
CONFIRMADOOpenAI
OpenAI apresenta BioBasicsBench com 100 tarefas de laboratório
@OpenAI ·
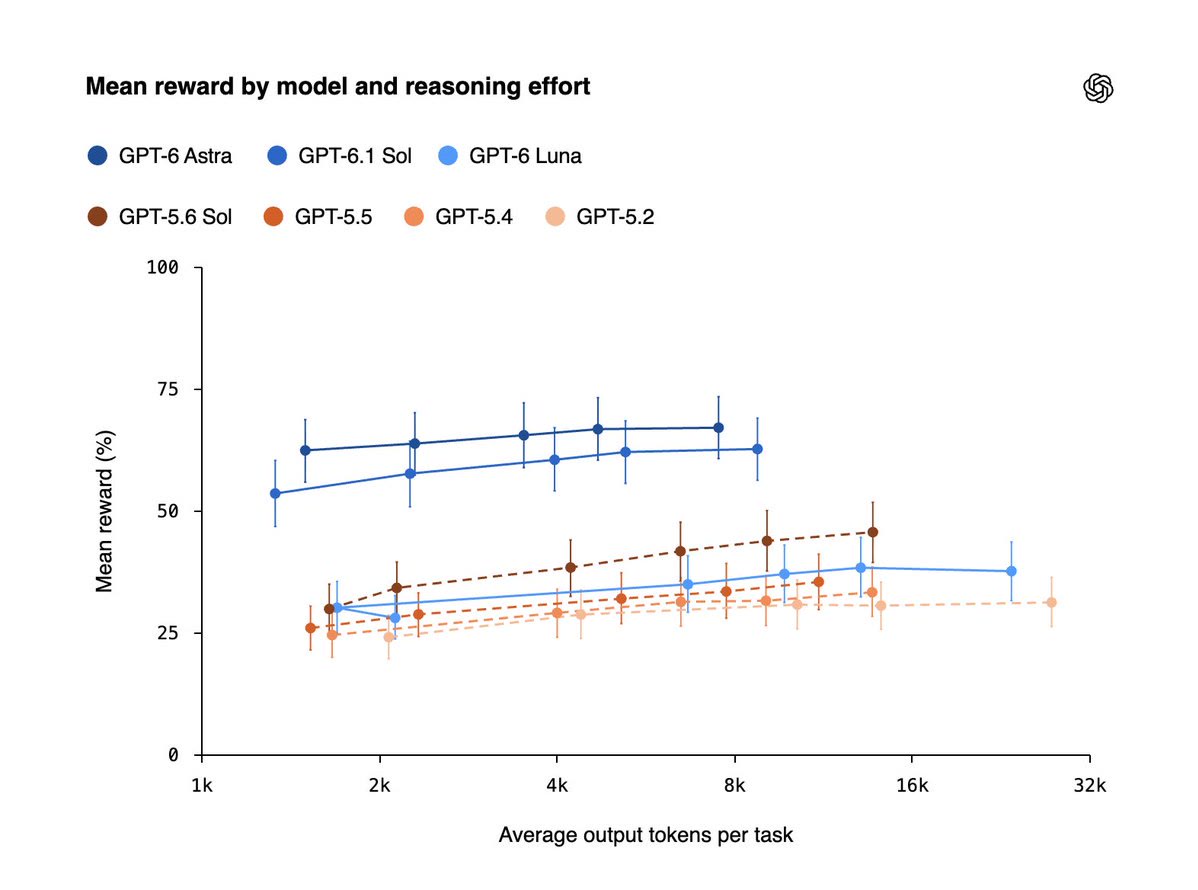
A OpenAI apresenta uma avaliação desenvolvida com a Ligo a partir de 100 tarefas de experimentos reais. O objetivo é testar interpretação de dados, identificação de erros e reconhecimento de conclusões sem evidência suficiente.
Uma nova maneira de avaliar como agentes de IA lidam com análises rotineiras da ciência experimental de laboratório — BioBasicsBench.
Desenvolvida com a Ligo, uma empresa de biotecnologia focada no desenvolvimento de enzimas, a avaliação usa 100 tarefas de experimentos reais para testar se agentes conseguem interpretar dados brutos de laboratório, identificar erros e reconhecer quando as evidências não sustentam uma conclusão.
Acelerar a pesquisa biológica começa por fazer corretamente o trabalho cotidiano. BioBasicsBench mostra onde os modelos precisam melhorar e nos ajuda a acompanhar o que esses ganhos significam para o progresso científico, a biossegurança e a bioproteção.
Ver original (texto do post como foi publicado)
A new way to measure how AI agents handle the routine analyses of wet-lab science—BioBasicsBench.
Developed with Ligo, a biotech company focused on enzyme design, the benchmark draws on 100 tasks from real experiments to test whether agents can interpret raw lab data, identify errors, and recognize when the evidence doesn’t support a conclusion.
Accelerating biological research starts with getting the everyday work right. BioBasicsBench shows where models need to improve, and helps us track what those gains mean for scientific progress, biosafety, and biosecurity.