03 · Tema 3 de 6 · máx. 116k views morno (calor 2 de 5; máx. 116k views)
Qwen apresenta QwenGyre e relata redução de ~44% no tempo de treinamento
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
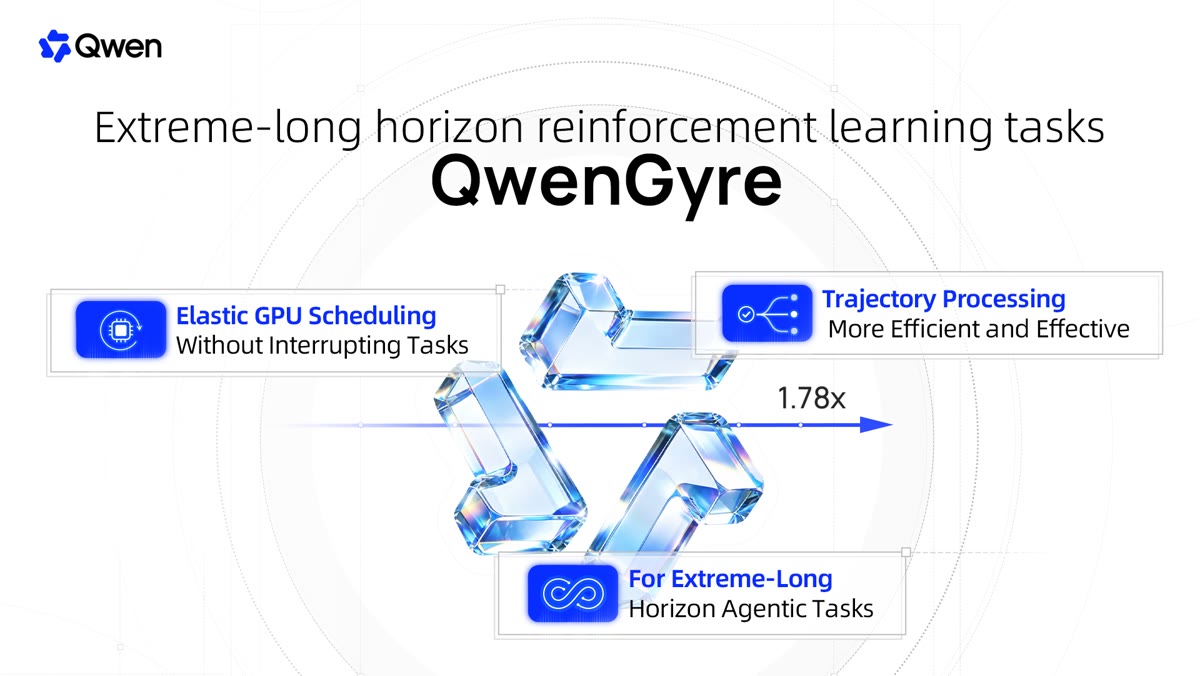
Em 12/10, às 10h11 BRT, a equipe Qwen, da Alibaba, apresentou o QwenGyre, um sistema de treinamento por reforço: a IA aprende com uma avaliação dos resultados que produz. Ele foi feito para trabalhos muito longos, nos quais o programa tenta caminhos diferentes, repete etapas e divide tarefas. O sistema redistribui as placas de processamento entre execução e treinamento sem interromper o trabalho em andamento e reaproveita as partes comuns das tentativas. Segundo a Qwen, aplicado ao Qwen3.8-2.4T-A95B, levou o resultado no NL2RepoBench de 52.5% a 58.5% em 48 etapas e reduziu o tempo total de treinamento em ~44% frente ao método Async. Trata-se de um anúncio de infraestrutura de treinamento, sem anúncio de um novo modelo disponível ao público. Os detalhes do artigo não foram confirmados na página oficial.
Fonte oficialArtigo indicado pela Qwen — conteúdo não confirmado na página (abre em nova aba)
Post âncora
CONFIRMADOOFICIAL Qwen — Alibaba
Qwen anuncia QwenGyre para treinar IA em tarefas muito longas
@Alibaba_Qwen ·
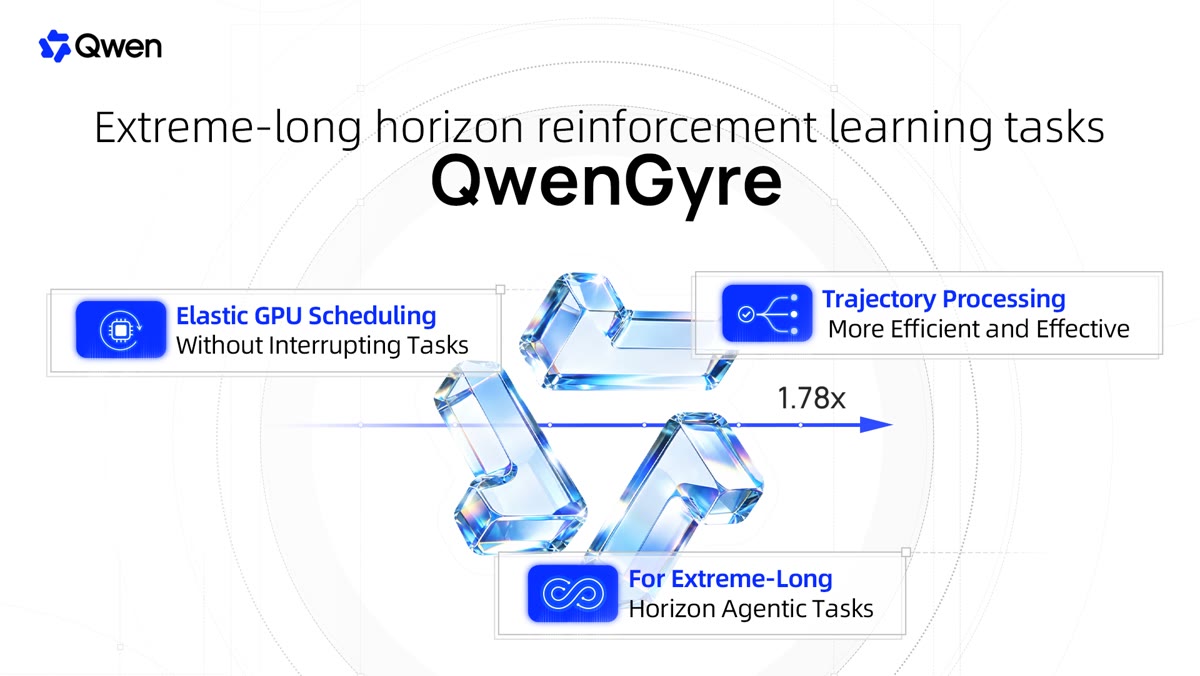
A Qwen apresentou um sistema que redistribui processamento e organiza tentativas durante o treinamento. Segundo a equipe, ele elevou o NL2RepoBench de 52.5% a 58.5% em 48 etapas e reduziu o tempo total de treino em ~44% frente ao Async.
Apresentamos QwenGyre, trazendo RL elástico para o treinamento de agentes de horizonte extremamente longo (XLong). ✨
Ele chega com dois projetos centrais: 🥳 - Elastic Scheduler: realoca GPUs entre execução e treinamento conforme a demanda muda — execuções em andamento nunca são interrompidas. Aceleração de até 1.85× em relação ao Colocate, 1.78× em relação ao Async. - Trajectory Processor: transforma execuções ramificadas (compactação, subagentes, novas tentativas) em árvores de trajetórias com prefixos compartilhados e amostras de treinamento limitadas e sem duplicação. O progresso parcial após o tempo limite ainda recebe pontuação.
Escalado para Qwen3.8-2.4T-A95B com ~700K tokens por execução, QwenGyre eleva o NL2RepoBench de 52.5% para 58.5% em 48 etapas, reduzindo o tempo de treinamento de ponta a ponta em ~44% em relação ao Async.
🔗 Leia o artigo:
Ver original (texto do post como foi publicado)
Introducing QwenGyre, bringing elastic RL to extreme-long-horizon (XLong) agent training. ✨
It launches with two core designs: 🥳 - Elastic Scheduler: reallocates GPUs between rollout & training as demand shifts—live executions never interrupted. Up to 1.85× speedup over Colocate, 1.78× over Async. - Trajectory Processor: turns branching executions (compaction, sub-agents, retries) into prefix-shared trajectory trees with bounded, deduplicated training samples. Partial progress after timeout still gets scored.
Scaled to Qwen3.8-2.4T-A95B with ~700K tokens per rollout, QwenGyre lifts NL2RepoBench from 52.5% to 58.5% in 48 steps, cutting end-to-end training time by ~44% vs Async.
🔗 Read the paper: