04 · Tema 4 de 6 · máx. 64,9k views morno (calor 2 de 5; máx. 64,9k views)
Teste da 8090 Labs mostra que o programa em volta da IA pode mudar bastante o resultado
Calor: o quanto o assunto está em alta no mercado agora, não opinião da redação.
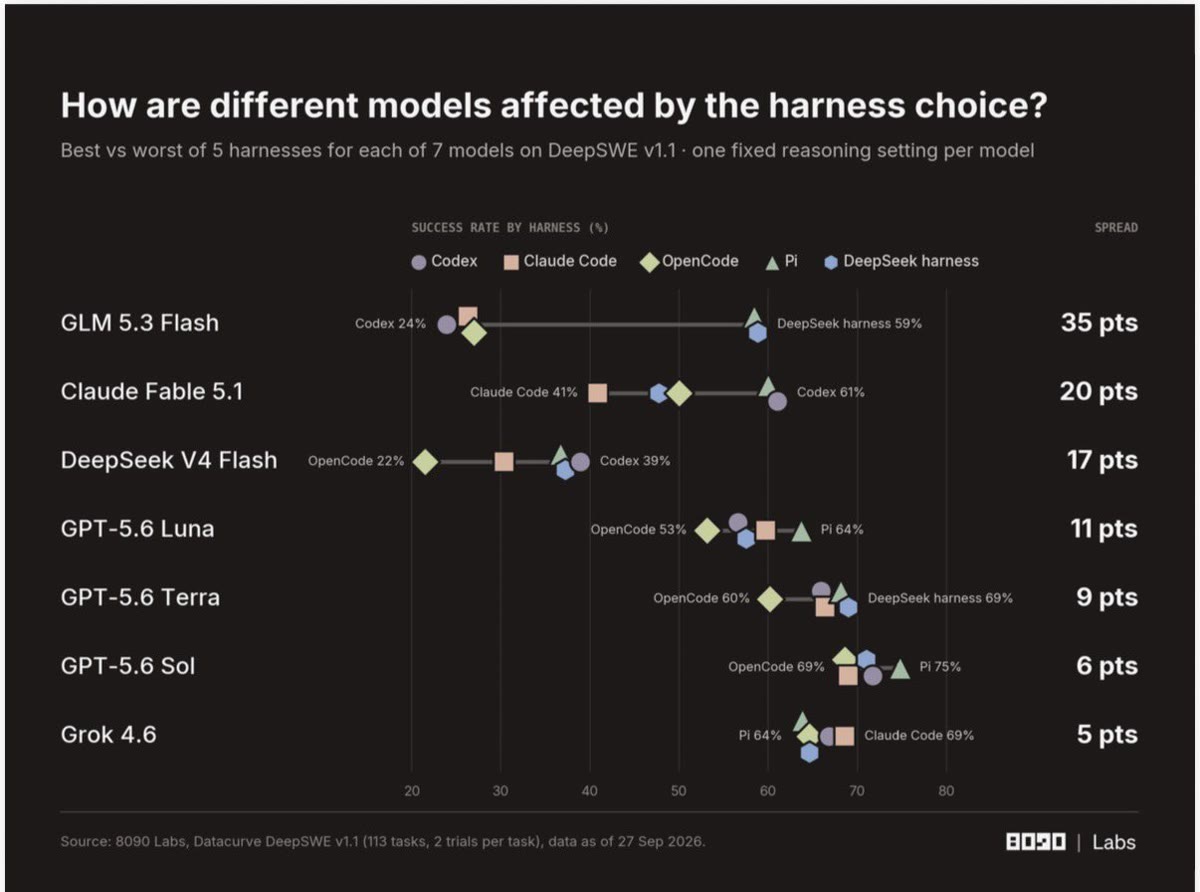
Em 12/10, às 14h52 BRT, Chamath Palihapitiya apresentou resultados de um teste que pediu à 8090 Labs: comparar 7 modelos em 5 harnesses, os programas que organizam os comandos, as ferramentas e o contexto de uma IA. Segundo ele, o Claude Fable 5.1 acertou 41% no Claude Code e 61% no Codex. O custo por tentativa também pode enganar: o GLM custou $0.22 por execução no Codex, mas $0.93 por sucesso; no Pi, os valores foram $0.25 e $0.43. A conclusão do autor é que escolher só pelo nome do modelo deixa de fora parte importante do desempenho. É um teste diferente do artigo sobre a IA reescrever essa estrutura, citado às 8h. A metodologia completa não foi confirmada na página indicada.
Post âncora
BUILDERRESPONSÁVEL pelo teste solicitado à 8090 Labs — Chamath
Chamath apresenta teste de 7 modelos em 5 harnesses
@chamath ·
Chamath relata um teste da 8090 Labs em que o programa que organiza o trabalho da IA alterou o desempenho e o custo por sucesso. Segundo ele, Claude Fable 5.1 acertou 41% no Claude Code e 61% no Codex.
Benchmarks de modelos não valem nada
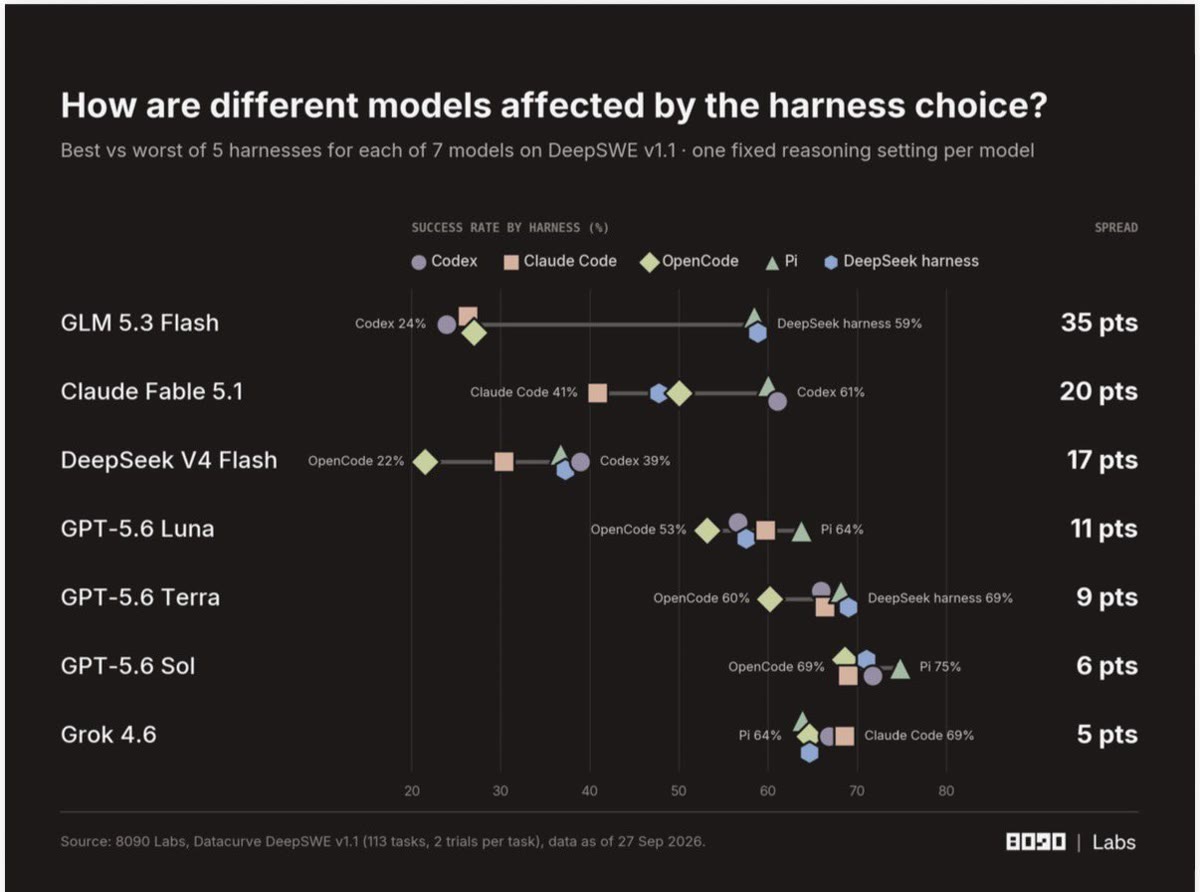
Como um modelo pode pontuar 24% e 59% nas mesmas 113 tarefas de programação?
Isso acontece quando você varia o harness que o envolve.
Tenho ignorado cada vez mais a maioria dos resultados recentes dos rankings de modelos. Em parte por exaustão e em parte porque melhorias em um ranking não aparecem no trabalho real.
Então pedi à equipe da 8090 Labs que medisse o que os rankings deixam de fora: o modelo e o harness juntos, em correções reais de bugs e funcionalidades de projetos de código aberto.
A 8090 Labs executou 7 modelos em 5 harnesses.
Aqui estão alguns resultados que eu não esperava:
- Claude Fable 5.1, da Anthropic, pontuou 41% no Claude Code e 61% no Codex, da OpenAI. Fez uma mediana de 28 chamadas de ferramentas em um e 66 no outro.
- As execuções mais baratas não foram o trabalho mais barato. GLM no Codex custou $0.22 por execução e $0.93 por sucesso. No Pi, custou $0.25 por execução e $0.43 por sucesso.
- GLM passou em uma tarefa nas duas tentativas 51 vezes em um harness e 16 vezes em outro.
- GPT-5.6 Sol e Grok 4.6 quase não se importaram com o harness em que estavam.
A conclusão é que, se você está escolhendo uma combinação de modelo/harness com base em um ranking só de modelos, está tomando uma decisão crítica com apenas metade da informação.
Ver original (texto do post como foi publicado)
Model Benchmarks Are Worthless
How can a model score 24% and 59% on the same 113 coding tasks?
It happens when you vary the harness that wraps it.
I’ve increasingly ignored most of the recent model leaderboard results. Partly from exhaustion and partly because improvements in a ranking don’t show up in the actual work.
So I asked the 8090 Labs team to measure what the leaderboards skip: the model and the harness together, on real bug fixes and features from open-source projects.
8090 Labs ran 7 models through 5 harnesses.
Here are a few results I didn't expect:
- Anthropic's Claude Fable 5.1 scored 41% in Claude Code and 61% in OpenAI's Codex. It made 28 tool calls at the median in one and 66 in the other.
- The cheapest runs weren't the cheapest work. GLM in Codex cost $0.22 a run and $0.93 per success. In Pi it cost $0.25 a run and $0.43 per success.
- GLM passed a task on both attempts 51 times in one harness and 16 times in another.
- GPT-5.6 Sol and Grok 4.6 barely cared which harness they were in.
The bottom line is that if you're picking a model/harness combo off a model-only leaderboard, you're making a critical decision based on only half the information.